Почему после объединения таблиц выросла сумма: проверяем JOIN и merge
После JOIN или merge изменились строки и сумма? Разбираем кратность ключа, пустые значения, потерянные операции и выбор версии справочника на проверенном примере pandas и SQLite.
Если после объединения таблиц выросла сумма, сначала проверьте, сколько строк справа соответствует каждой исходной строке слева. JOIN не обязан возвращать одну строку на операцию: два совпадения создают две пары и повторяют её сумму. Зафиксируйте исходный набор, полный ключ и ожидаемую кратность, затем отдельно проверьте повторённые строки, потерянные строки и несовпадения. Удаление дублей уже готового результата может скрыть причину.
Эта проверка нужна, когда к выгрузке операций добавляют название товара, тариф, категорию или другой справочный признак. Соединение строк по ключу отличается от append — добавления одной таблицы под другую. Ниже разобран небольшой искусственный пример, воспроизведённый в pandas 3.0.1 и SQLite 3.53.1. Указания для Power Query основаны на документации: запуск Excel и Power Query здесь не проводился.
Сначала определите, что должно сохраниться
Запишите результат словами: «К каждой строке операции добавить не больше одной действующей записи справочника; все операции сохранить». Это контракт many-to-one, или m:1. Слева код товара может встречаться много раз, потому что товар покупали повторно. Справа комбинация полей, по которой выполняется поиск, должна однозначно выбирать справочную запись. Если цель другая, например вывести каждую поставку заказа, размножение строк может быть ожидаемым.
Проверьте единицу наблюдения и состав ключа до выбора типа соединения. Код заказа не равен коду позиции заказа, а код товара без магазина может оказаться неполным ключом. Для контроля добавьте идентификатор исходной строки, здесь sid. Он различает две настоящие операции одного товара. Индекс, назначенный внутри зафиксированной выгрузки, подходит для такой сверки, но не становится постоянным идентификатором клиента или операции между обновлениями.
Выделите четыре независимых требования: какие исходные строки обязаны остаться; сколько копий каждой допустимо; какой справочный вариант разрешён; что делать при отсутствии совпадения. Равные общие итоги проверяют лишь часть этого договора. Когда соединение меняет единицу результата, повторённая сумма операции ещё не становится суммой поставки, тарифа или распределённой доли. Для такого показателя понадобится отдельное правило расчёта.
Почему LEFT JOIN дал семь строк вместо пяти
В левой таблице пять операций: l1 — north/A на 100 копеек; l2 — north/A на 200; l3 — north/B на 300; l4 — north с пустым sku на 400; l5 — south/A на 500. Это искусственные суммы в целых условных копейках. Исходный итог — пять строк и 1 500 копеек. Ключ соединения состоит из tenant и sku; north и south обозначают разные области учёта.
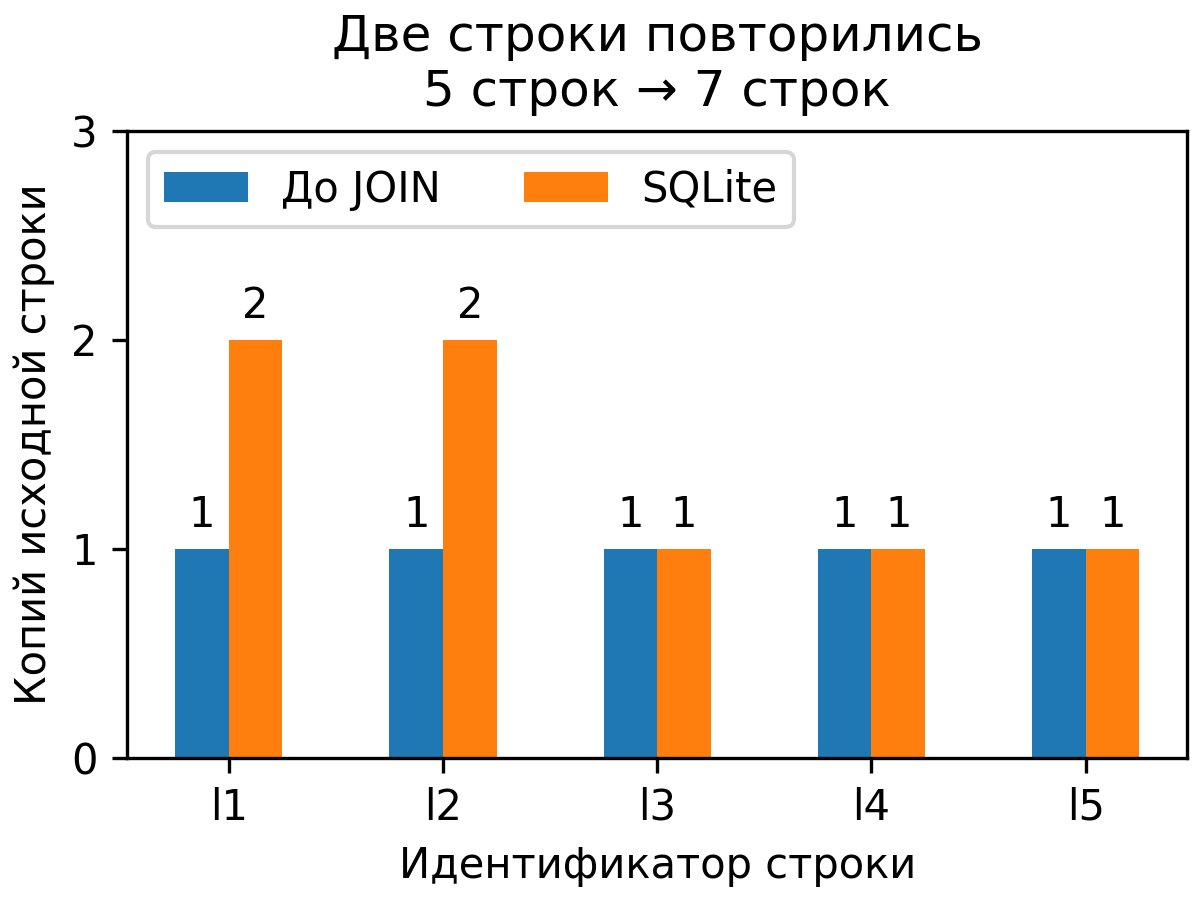
Справа для north/A лежат две версии справочника, old и new. Для north/B есть одна запись, для south/A — одна. Ещё две записи имеют пустой sku, а north/C присутствует только справа. При обычном равенстве в SQLite строки l1 и l2 находят по две записи north/A. Операции l3 и l5 находят по одной. Строка l4 сохраняется без пары, потому что сравнение через обычное равенство с SQL NULL не даёт совпадения.
Результат содержит семь строк и 1 800 копеек. Прибавка 300 равна дополнительной копии 100 и дополнительной копии 200. LEFT JOIN сохранил все пять исходных sid, но не гарантировал по одной выходной строке на каждый. Полезный диагностический результат здесь — не только итоговая сумма, а кратность: l1 и l2 встречаются дважды, остальные sid один раз.
Для группы ключа с a строками слева и b совпадениями справа обычное соединение даёт a × b пар. В нашем north/A две операции и две справочные версии создают четыре строки. Это следствие условий соединения, а не доказательство ошибки движка. Отдельная исходная строка LEFT JOIN без совпадения остаётся один раз; в INNER JOIN она исчезнет. Правило кратности нужно применять с учётом выбранного типа соединения.
Найдите неоднозначный ключ до раскрытия результата
Проверяйте уникальность полного ключа справа до объединения. Уникальный rid различает сами справочные записи, но не делает уникальной комбинацию tenant и sku. В pandas duplicated с subset, содержащим оба поля, и keep=False показывает всех участников повторяющихся групп. В SQL сгруппируйте по тем же полям и посчитайте строки каждой группы. Проверку пустых ключей ведите отдельно от проверки обычных значений.
Сравните обнаруженные группы с требованиями предметной области. Две версии одного товара могут быть нормальными историческими данными. Две разные цены на одну дату могут быть конфликтом. Несколько доставок на один заказ могут быть ожидаемой детализацией. Один и тот же технический признак «ключ повторяется» не объясняет, какую строку разрешено выбрать и можно ли суммировать результат.
В pandas передайте validate='m:1', если слева допустимы повторы, а справа ключ обязан быть уникальным. В нашем исходном примере эта проверка отклоняет соединение. validate='1:1' требует уникальности обеих сторон; '1:m' — левой. Значение 'm:m' разрешает соответствующую кратность и не проверяет уникальность. Оно не является способом подтвердить, что неожиданно выросшая сумма допустима.
В Power Query сначала выполните слияние как вложенную таблицу и проверьте число найденных записей в ней для каждой исходной строки. Table.NestedJoin сохраняет такой промежуточный результат, а Table.ExpandTableColumn раскрывает выбранные поля. Посчитать строки вложенной таблицы можно через Table.RowCount. Если ожидалось не больше одной записи, значения больше единицы требуют разбора до раскрытия и суммирования.
Сравните число строк до слияния и после раскрытия, сохранив sid. В обычном сценарии с левым внешним соединением рост именно на раскрытии — повод проверить несколько найденных записей, но одного числа недостаточно для окончательного вывода. Убедитесь в выбранном JoinKind, составе полей, преобразованиях и фактическом поведении своего запроса. Объявленные метаданные ключа не заменяют проверку значений на нужной стадии.
Профиль Power Query по умолчанию может быть построен только по первым 1 000 строкам. Для проверки всего справочника выберите профиль полного набора или отдельный расчёт по всем строкам. Чистое начало таблицы не доказывает отсутствия конфликтов дальше. Если ошибка проявляется нерегулярно, сравнивайте идентичные снимки: изменившийся источник способен изменить кратность между двумя обновлениями.
Не теряйте часть ключа и не «лечите» типы вслепую
Если из условия нашего SQLite JOIN убрать tenant и оставить sku, код A начнёт связывать north с south. Получится одиннадцать строк и 3 100 копеек. Названия товаров могут выглядеть правдоподобно, хотя области учёта уже смешаны. Проверяйте не только наличие нужных столбцов, но и порядок пар полей, выбранные таблицы, квалификацию имён и условия каждого этапа цепочки соединений.
Не полагайтесь на совпадающие имена столбцов как на подтверждение ключа. В pandas merge без явно заданного on может выбрать общие имена колонок, а DataFrame.join обычно работает с индексом и имеет другой договор. Укажите ключ осознанно. Добавленный позднее одноимённый столбец не должен незаметно менять условие соединения. После нескольких JOIN найдите первый этап, на котором кратность sid отклонилась от ожидания.
Одинаковое отображение тоже не гарантирует одинакового значения. Пробелы, управляющие символы, регистр, Unicode-нормализация и типы требуют проверки. В отдельном опыте SQLite текстовый код 001 отличался от текстового 1, но сравнение с колонкой NUMERIC могло уравнять их. Ведущие нули могут быть частью идентификатора. Превращать все коды в числа ради совпадений опасно.
Сначала сохраните исходное значение, затем создайте проверяемую нормализованную копию и сравните группы до и после преобразования. Trim, приведение регистра или удаление управляющих символов способны объединить разные реальные ключи. Встроенный NOCASE в проверенном SQLite-примере учитывал регистр ASCII, но не уравнивал кириллические варианты. Правила конкретной сортировки и культуры нельзя переносить на все базы или инструменты.
Пустой ключ — отдельное решение, а не универсальный NULL
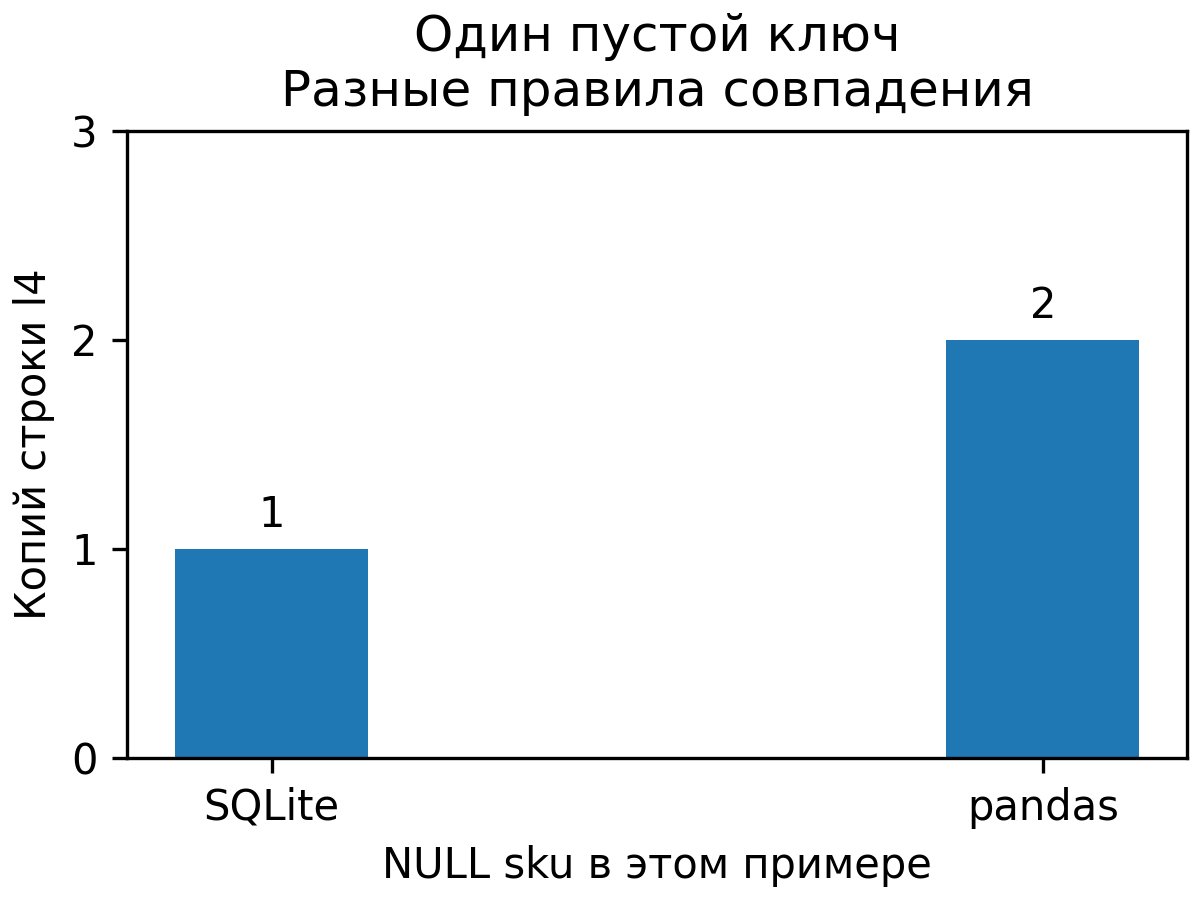
В pandas 3.0.1 строка l4 с отсутствующим sku нашла обе правые записи с отсутствующим sku. Поэтому результат того же left merge содержал восемь строк и 2 200 копеек: добавилась ещё одна копия суммы l4. В проверенном SQLite-соединении через обычное равенство l4 осталась одной строкой без совпадения. Различие правил обработки пропусков меняет и кратность, и сумму.
Это не означает, что любое SQL-соединение всегда ведёт себя одним способом. Существуют операторы и условия для сравнения с учётом NULL. Скаляры M тоже имеют свои правила: поведение выражения с null не доказывает поведение любого свёрнутого соединения Power Query с внешним источником. Уточняйте движок, оператор, типы и фактический маршрут выполнения. Excel и Power Query нужно проверить на собственном коротком примере.
Решите, означает ли пустой код допустимую категорию или отсутствие сведений. Если совпадения по пропускам запрещены, отделите неполные правые ключи от справочника для соединения, а левые строки сохраните как несовпавшие для разбора. Не заменяйте все пропуски одним выдуманным кодом: тогда неизвестные сущности смогут совпасть друг с другом. Не удаляйте автоматически денежные операции только потому, что справочник неполон.
Для поиска несовпавших строк используйте инструмент с явно понятной семантикой и тем же полным условием. В pandas помогает indicator; в SQL — проверка отсутствия подходящей пары, например коррелированный NOT EXISTS. В нашем отдельном SQLite-примере NOT IN со значением NULL справа не вернул ожидаемые строки. NOT EXISTS нельзя механически подставить в любой запрос: состав ключа и политика пропусков должны сохраниться.
Почему равная сумма ещё не подтверждает правильность
Другой искусственный набор содержит b1/A на 100 копеек, b2/B на 100 и b3/C на 200. Справа две записи A, одна C и ни одной B. После INNER JOIN b1 повторяется, b2 исчезает, b3 сохраняется. И до, и после остаются три строки и 400 копеек. Проверка только двух итогов пропускает взаимную компенсацию ошибок.
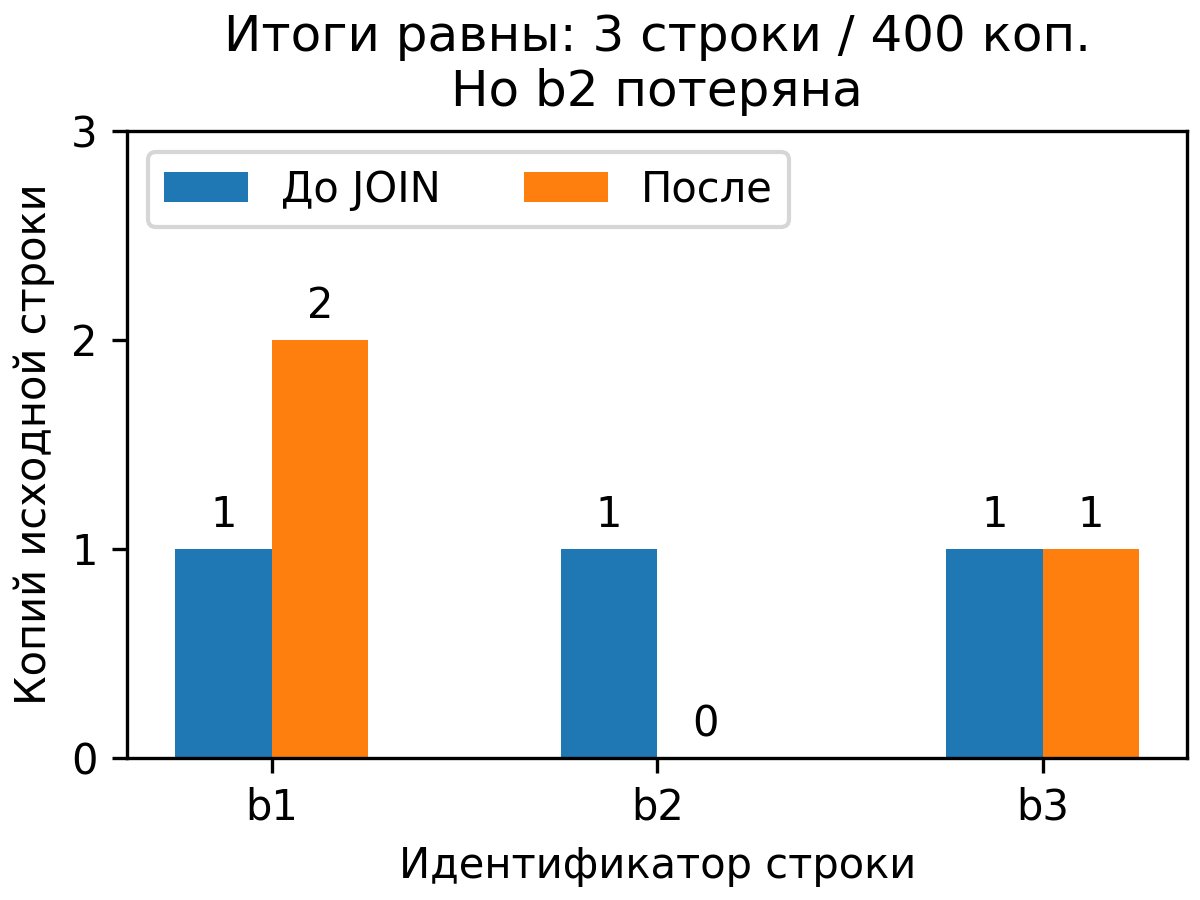
Ведите сверку по идентификаторам исходных строк: какие отсутствуют, какие повторены и сколько раз. Даже неизменная сумма по группе не исключает такую компенсацию внутри группы. Повторение операции с нулевой суммой может вовсе не изменить денежный итог. Для обязательных строк проверяйте присутствие и допустимую кратность каждой, а для добавленных атрибутов — соответствие правильной справочной записи.
Отдельно проверяйте полноту совпадений. validate='m:1' может пройти, хотя часть левых ключей не найдена: уникальность правой стороны не означает её полноту. Индикатор left_only показывает такую строку, both — найденную пару, right_only во внешней сверке — запись, не использованную этим левым набором. Для поиска несовпадения в SQL выбирайте гарантированно непустой идентификатор правой записи; её обычное поле может быть NULL и при успешном совпадении.
Правые записи без пары не обязательно лишние. Справочник может содержать товары без продаж за выбранный период или записи другой области. Отмечайте причину и границы выборки. Semi-join и anti-join удобны для отбора исходных строк по наличию либо отсутствию пары, но не добавляют правые атрибуты и имеют собственные правила пропусков. Они не заменяют проверку версии, нужной для обогащения.
Исправьте выбор справочной записи, а не внешний вид итога
В основном примере заранее задано правило: для каждой непустой комбинации tenant и sku разрешена запись с максимальной version. Это только правило искусственного набора. После его применения и отделения пустых правых ключей left merge возвращает пять исходных sid по одному разу и 1 500 копеек. Строка l4 остаётся без справочной пары и требует разбора, а не незаметного удаления.
В реальных данных «взять последнюю» требует определения. Нужны дата действия, статус, область учёта и разрешение равных значений. Максимальная дата загрузки не обязательно означает действующий тариф на дату операции. Для исторического справочника проверьте интервалы действия и их пересечения; при нескольких допустимых кандидатах зафиксируйте конфликт. Однозначный технический порядок не доказывает правильность бизнес-выбора.
Удаление полных дублей здесь не помогает: rid, version и label различают все правые записи. Удаление повторов только по ключу способно оставить произвольный вариант. В проверенном pandas-примере выбор первой строки зависел от порядка входа. В SQL нумерация строк при равных значениях сортировки тоже не определяет правильного победителя. Не подменяйте правило справочника сортировкой ради удобной суммы.
Table.Distinct в Power Query не следует считать обещанием сохранить именно нужную версию без продуманного процесса. Table.Buffer не выбирает актуальную запись, может замедлить запрос и не создаёт общий снимок для всех независимых обращений к источнику. Такие средства имеют техническое назначение; неоднозначные данные требуют отдельного правила выбора, а затем повторной проверки уникальности ключа.
Агрегировать правую таблицу тоже можно только по смыслу. Если нужны сумма поставок или число событий на ключ, сначала рассчитайте такой показатель с явными единицами и группировкой, затем соединяйте результат. Суммировать цены разных версий, выбрать минимальное название или усреднить тариф ради одной строки — не нейтральная очистка. Это меняет показатель и должно быть отдельным согласованным решением.
Проверьте фильтры и сохранение исходных операций
Условие на правую сторону внутри ON и такое же условие после LEFT JOIN в WHERE могут дать разные результаты. В нашем опыте требование version=2 внутри ON сохраняет все пять левых sid, оставляя часть без пары. То же требование в WHERE оставляет только l1, l2 и l5: строки без подходящего значения исчезают уже после соединения.
Поэтому не переносите фильтр между стадиями только ради ускорения или удобства. Сначала определите, нужно ли сохранить операции без нужной версии, либо результат должен содержать лишь подтверждённые совпадения. После изменения проверяйте потерянные sid. Даже добавление проверки «поле справа заполнено» может изменить назначение внешнего соединения. В Power Query отслеживайте аналогично шаг, на котором фильтруется раскрытая таблица.
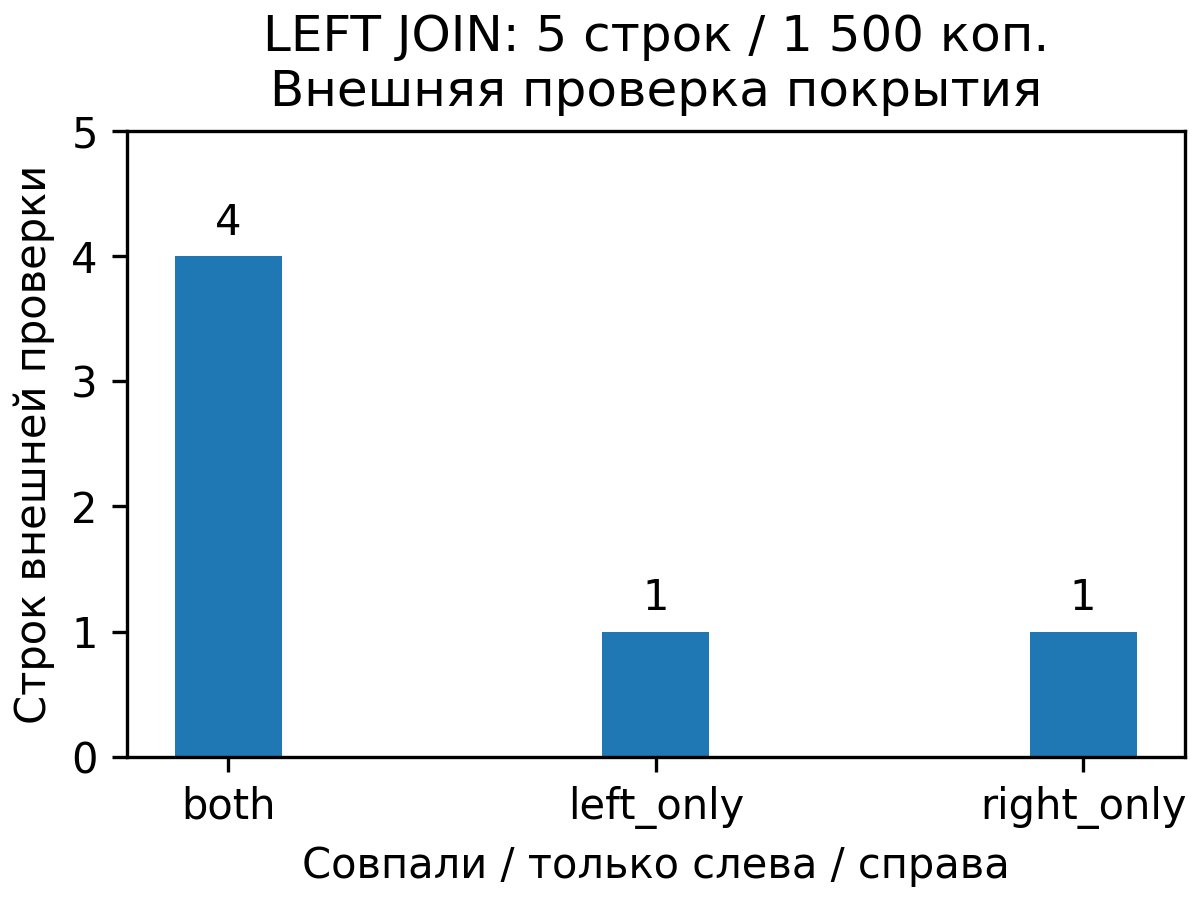
После исправления нашего основного примера отдельная внешняя сверка показывает четыре both, одну left_only и одну right_only. В этой сверке шесть строк, потому что она включает неиспользованный правый ключ north/C. Сам левый результат по-прежнему содержит пять операций. Не сравнивайте количество строк разных типов соединения без понимания, какие сущности включены в каждую таблицу.
Короткая приёмка перед обновлением отчёта
- Зафиксируйте обе выгрузки, период, фильтры, единицы суммы, версии инструментов и полный ключ; сохраните sid исходных строк.
- Проверьте типы, пропуски и группы ключей справа; сопоставьте ожидаемую кратность с выбранным типом JOIN или merge.
- Найдите первый этап с изменившейся кратностью; отдельно перечислите повторённые, потерянные и несовпавшие строки.
- Разберите неоднозначные версии по предметному правилу; проверьте, что нормализация или агрегация не создала ложных пар.
- Сверьте исправленный результат по sid, сумме, обязательным группам и правильным правым атрибутам; сохраните нерешённые несовпадения отдельно.
Работайте с согласованными снимками. Если источник обновляется, одинаковый запрос в разное время может читать разные данные. Для PostgreSQL даже последовательные чтения при Read Committed не обязаны видеть один снимок; подходящий уровень изоляции выбирают по договору операции. Он не заменяет завершённость выгрузки или проверку бизнес-периода. Для файлов полезны сохранённые версии и контрольные суммы, а не сравнение с уже перезаписанной таблицей.
При подсчётах различайте число строк и число непустых значений. COUNT(*) и подсчёт заполненного столбца могут отличаться; в pandas groupby.size и count отвечают на разные вопросы, а группы с пропусками требуют явного внимания. Сумма пустой группы тоже зависит от инструмента и параметров. Зафиксируйте эти правила в контроле, чтобы отсутствие данных не выглядело автоматически как подтверждённый ноль.
Если причиной стали неверные исходные значения, используйте отдельный разбор пропусков, дублей и невозможных значений, сохранив найденные группы ключа. Завершённое исправление означает, что каждый обязательный sid имеет разрешённое число копий и правильную пару, а несовпадения объяснены. Одна удобная сумма, снятая проверка validate или случайно выбранная версия справочника такой приёмкой не являются.