Из столбцов в строки и обратно: когда разворот таблицы теряет данные
Как проверить pivot и unpivot: сохраняем ключи, пропуски, типы и исходные записи. Разбираем агрегацию, двойной счёт и потерю точности на примерах pandas и SQLite.
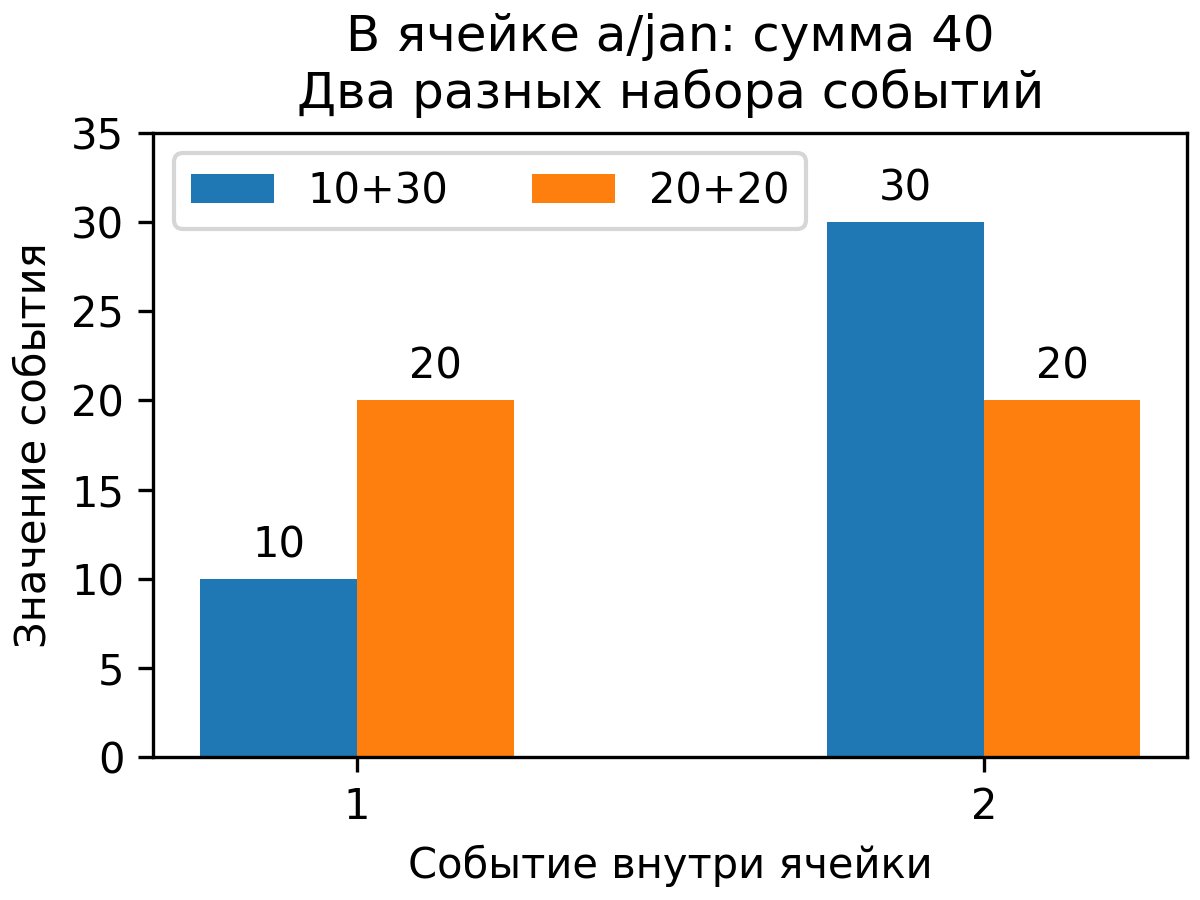
Перевести месяцы из столбцов в строки обычно помогает unpivot, в pandas — melt. Обратный pivot возвращает исходные ячейки, только если сохранены их ключи, значения и правила представления. Если два события уже сложили в одну ячейку, разворот назад не восстановит каждое событие. Например, значения 10 и 30 дают ту же сумму 40, что 20 и 20. Чтобы проверить результат, нужны исходные записи, карта пропусков и схема типов, а не только общий итог.
Предположим, вы получили отчёт с колонками месяцев, превратили его в длинную таблицу, добавили расчёт и снова собрали привычный отчёт. Числа выглядят правдоподобно, но исчезла пустая строка, изменился большой код или удвоился бюджет. Ниже разберём, на каком шаге это происходит и что сохранить заранее. Числовые примеры выполнены на искусственных данных в pandas 3.0.1 и SQLite 3.53.1; действия Power Query сверены с документацией, но в его интерфейсе не испытывались.
Какую операцию вы действительно хотите выполнить
В широком представлении одна строка содержит объект и несколько колонок измерений: например, id, январь, февраль. В длинном те же измерения размещены в строках: id, месяц, значение. Название бывшей колонки становится значением поля «месяц», а идентификатор объекта повторяется для каждого измерения. Такой формат удобен для добавления очередного периода, фильтрации и группировки по месяцу. Он также меняет число строк: это ожидаемо, если строки теперь описывают ячейки прежних измерений.
Транспонирование меняет местами строки и столбцы. Оно не выбирает бизнес-ключ и не вводит само по себе пару «показатель — значение». Изменение формы массива, например reshape в NumPy, тоже работает с позициями элементов и заданным порядком обхода. Эти операции подходят для своих задач, но совпадение слова «развернуть» не делает их взаимозаменяемыми. Сначала нарисуйте желаемые поля и две-три строки результата: нужно ли повернуть вид таблицы, развернуть измерения или посчитать сводный итог?
Определите, что различает две исходные записи. Для одного отчёта достаточно id объекта; для другого нужны объект, филиал и дата. Если это ещё неясно, пригодится разбор единицы наблюдения и полей таблицы. При переходе к длинному виду к ключу записи добавляется название измерения. После него один объект может законно иметь несколько строк. Уникальность только id проверяет уже другую единицу данных и даст ложную тревогу.
Что сохранить до первого разворота
В нашем простом наборе сначала стоит объект b: март 30, январь 10, затем объект a: март 40, январь 20. Имеются две строки и четыре измеренные ячейки; сумма измерений равна 100. После melt с явно выбранными мартом и январём получились четыре строки, сумма осталась 100. Затем pivot, восстановление исходного порядка и типов вернули этот набор точно. Это пример обратимого преобразования при однозначных ключах, а не обещание для любого файла.
До преобразования сохраните список полей идентификации, список измерений, тип каждой колонки и нужный порядок строк и колонок. В примере pivot расположил объекты как a, b, а месяцы — январь, март. Исходный порядок b, a и март, январь пришлось применить отдельно. Если порядок важен для экспорта, сравнения или пользователя, включите его в договор проверки. Перестановка равных по смыслу записей может быть допустима, но это должно быть явно решено.
Индекс pandas не становится постоянным идентификатором только потому, что его удалось сохранить. Обычный melt заново нумерует результат. При ignore_index=False исходные метки сохраняются, но повторяются по числу выбранных измерений: row-b и row-a встречаются дважды. Полученный индекс уже не уникален. Для восстановления конкретного снимка можно заранее добавить отдельный идентификатор записи; устойчивость такого идентификатора между выгрузками требует собственного правила, особенно если исходный порядок меняется.
- Ключ ячейки: все поля исходной записи плюс измерение или период.
- Смысл значения: единица измерения, допустимый диапазон и исходный тип.
- Отсутствие: явный пропуск, отсутствовавшая запись и настоящий ноль учитываются раздельно.
- Схема: имена, типы, порядок и правило допуска новых колонок сохраняются до преобразования.
Почему pivot отвергает данные, а сводная таблица их принимает
Для обычного pivot одна комбинация ключа строки и названия будущей колонки должна определять одну ячейку. Если у объекта a за январь стоят два значения — 10 и 30, — какую из них поместить в единственную колонку января? В нашем запуске pandas pivot сообщил ValueError. Даже два совершенно одинаковых значения 10 и 10 под одним ключом вызывают такую ошибку. Совпадение значений не доказывает, что две исходные записи являются одним событием.
pivot_table решает другую задачу: группирует значения и применяет агрегат. В проверенном примере его агрегация по умолчанию дала среднее 20 для значений 10 и 30; явно указанная сумма дала 40. Оба результата могут быть правильными сводками, если именно это требовалось. Для сохранения событий они недостаточны. Найдите все строки неоднозначной комбинации, проверьте полноту ключа и выясните, являются ли это разные события, версии одной записи или ошибочные повторы.
Число событий рядом с суммой тоже не возвращает их значения. Заменим 10 и 30 на 20 и 20: получим те же два события, сумму 40 и среднее 20, хотя исходные наборы различаются. В нашей лаборатории совпали и полные сводные результаты двух разных четырёхстрочных наборов. Если требуется восстановить каждую операцию, сохраняйте её самостоятельный ключ и исходный набор. Удаление дублей или выбор first допустимы только после предметного решения о том, какие записи разрешено объединить.
Пропуск, ноль и отсутствие строки дают разные результаты
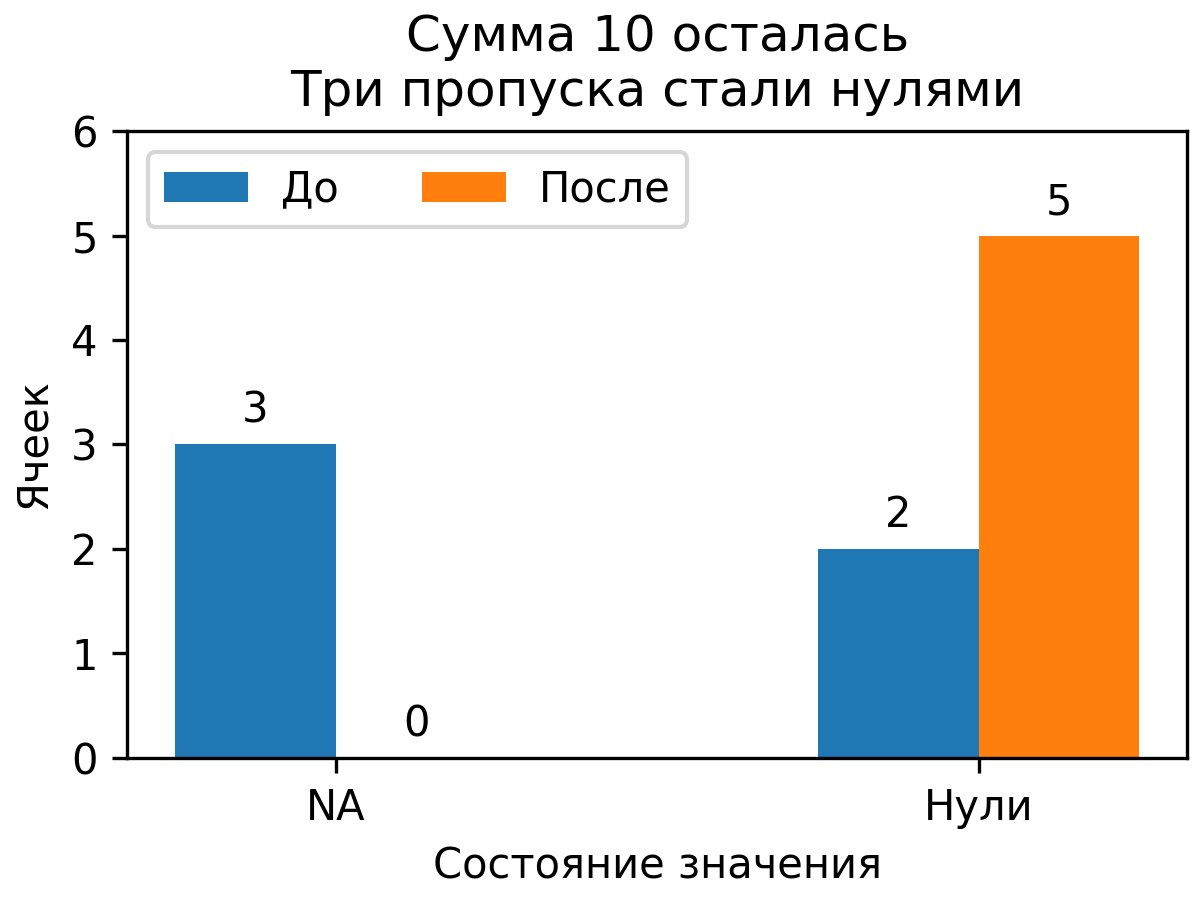
Возьмём три объекта и два месяца. У a январь равен 10, февраль неизвестен; у b оба месяца неизвестны; у c оба месяца равны нулю. Это шесть ячеек: три пропуска, два нуля и одно значение 10. В pandas melt сохранил все шесть ячеек. После обратного pivot и восстановления Int64 получился исходный набор. Сохранение пропуска важно: неизвестное значение не является подтверждением отсутствия продаж, расхода или другого события.
Теперь удалим из длинной таблицы строки с отсутствующим значением. Останутся три ячейки: январь a и два нуля c. Объект b исчезнет целиком, хотя он присутствовал в исходном отчёте. Обратный pivot не узнает, что такую строку нужно создать. Если бизнес-правило действительно исключает полностью неизвестные записи, сохраните это решение и перечень исключений. Если требуется обратимость, оставляйте пропуски либо отдельно храните исходный набор объектов и состояние каждой ячейки.
Заполнение пропусков нулём даёт другую потерю. В том же наборе сумма останется 10, но число нулей вырастет с двух до пяти, а пропусков станет ноль. Итоговая сумма не обнаружит изменения. Проверяйте карту отсутствующих значений и причину заполнения: измерено ноль, данных пока нет или запись неприменима. Разбор пропусков, дублей и невозможных значений поможет разделить такие состояния до преобразования. Сам разворот не решает, какое из них можно заменить нулём.
Есть ещё отличие: строка с явным пропуском и сочетание, которого вообще не было. В длинном наборе у нас записаны a/январь со значением 10, a/февраль с пропуском и b/январь со значением 20. Пары b/февраль нет. При сборке прямоугольной широкой таблицы для неё появляется пустая ячейка. После разворота всех ячеек обратно получается четыре строки и два пропуска. По одному полю значения невозможно определить, какой пропуск существовал раньше, а какой создан новой формой.
Сохраните отдельный признак присутствия исходной пары до заполнения прямоугольника. В лаборатории такая маска позволила отобрать после обратного разворота именно три исходные комбинации ключа и месяца, оставив явный пропуск a/февраль и исключив отсутствовавшую b/февраль. Это решение для сохранения состава записей. Дополнительно сравните значения, типы и порядок: совпадение трёх пар ещё не доказывает все свойства исходного файла. Если хранить маску нельзя, сохраняйте оригинальный длинный набор как самостоятельный источник.
Разделите контроль количества строк и заполненных значений. DataFrame.count в pandas считает непустые ячейки, а не все строки; обычный sum пропускает NA и может дать ноль даже для полностью неизвестного набора. При требовании хотя бы одного действительного значения у суммы задают min_count. Контроль общего числа объектов, числа исходных пар и карты пропусков нужен независимо. Для сравнения частот записей тоже проверьте политику отсутствия: value_counts по умолчанию исключает строки с NA.
Почему после unpivot удваивается бюджет
У объекта a бюджет 100, у b — 200; каждый имеет два месячных показателя. Исходный бюджет по объектам составляет 300. Когда месяцы развернули в строки, бюджет правильно повторился возле каждого месяца: две строки с 100 и две с 200. Но сумма этой колонки теперь равна 600. Сумма собственно месячных измерений осталась 100. Преобразование не создало дополнительный бюджет: изменилась кратность атрибута в новом представлении, а последующий расчёт выбрал неверную единицу суммирования.
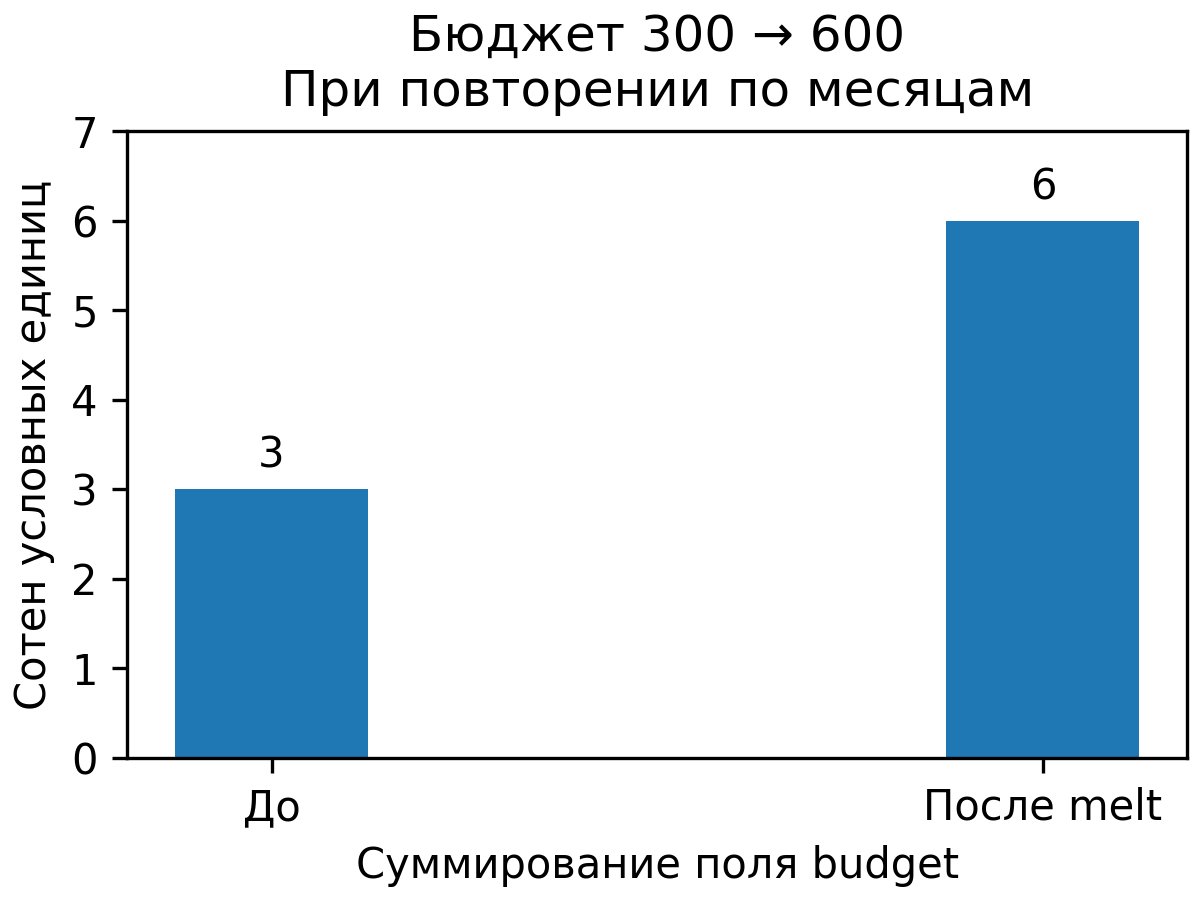
Для расчёта бюджета сначала вернитесь к его единице учёта — в данном примере объекту. Проверьте, что у одного объекта бюджет одинаков во всех повторённых строках и что исходные объекты сохранены. Уже затем применяйте объявленное правило получения одного значения на объект. В реальном отчёте бюджет может меняться по версии или периоду; тогда ключ должен это учитывать. Выбор max, first или удаление повторов без проверки способен скрыть разные утверждённые значения вместо исправления двойного счёта.
Сходная проблема возникает с единицами измерения. Количество товаров, ставка, площадь и сумма могут выглядеть как числа, но складывать их между собой нельзя. Название показателя после unpivot должно сохранять смысл значения и его единицу. Оставьте атрибуты объекта отдельно от измерений, а группы разных измерений обрабатывайте по своей схеме. Это также поможет избежать неожиданного общего числового типа: одинаковая колонка «значение» не гарантирует одинаковую точность для количества и дробной ставки.
Общий тип может незаметно изменить целое число
В искусственном примере колонка count имеет nullable-тип Int64 и содержит целое 9007199254740993, а rate имеет Float64 и дробные значения. Когда обе колонки поместили в один melt, общая колонка значения получила тип Float64. Наше большое целое стало 9007199254740992: потерялась единица. Число строк и названия показателей при этом не указывали на ошибку. Наличие Int64 в исходной таблице не защитило число после его включения в общую колонку с дробным измерением.
В этом же наборе два отдельных melt, каждый для своей группы измерений, сохранили count как Int64 с точным большим целым, а rate — как Float64. Для нескольких периодов это означает заранее определить группы однородных показателей и их поля значений. Можно сохранить отдельные типизированные колонки или отдельные наборы с явным ключом. Выбор зависит от дальнейшей задачи. Если позднее снова объединить все значения в один дробный столбец, ту же проверку точности придётся применить на новом шаге.
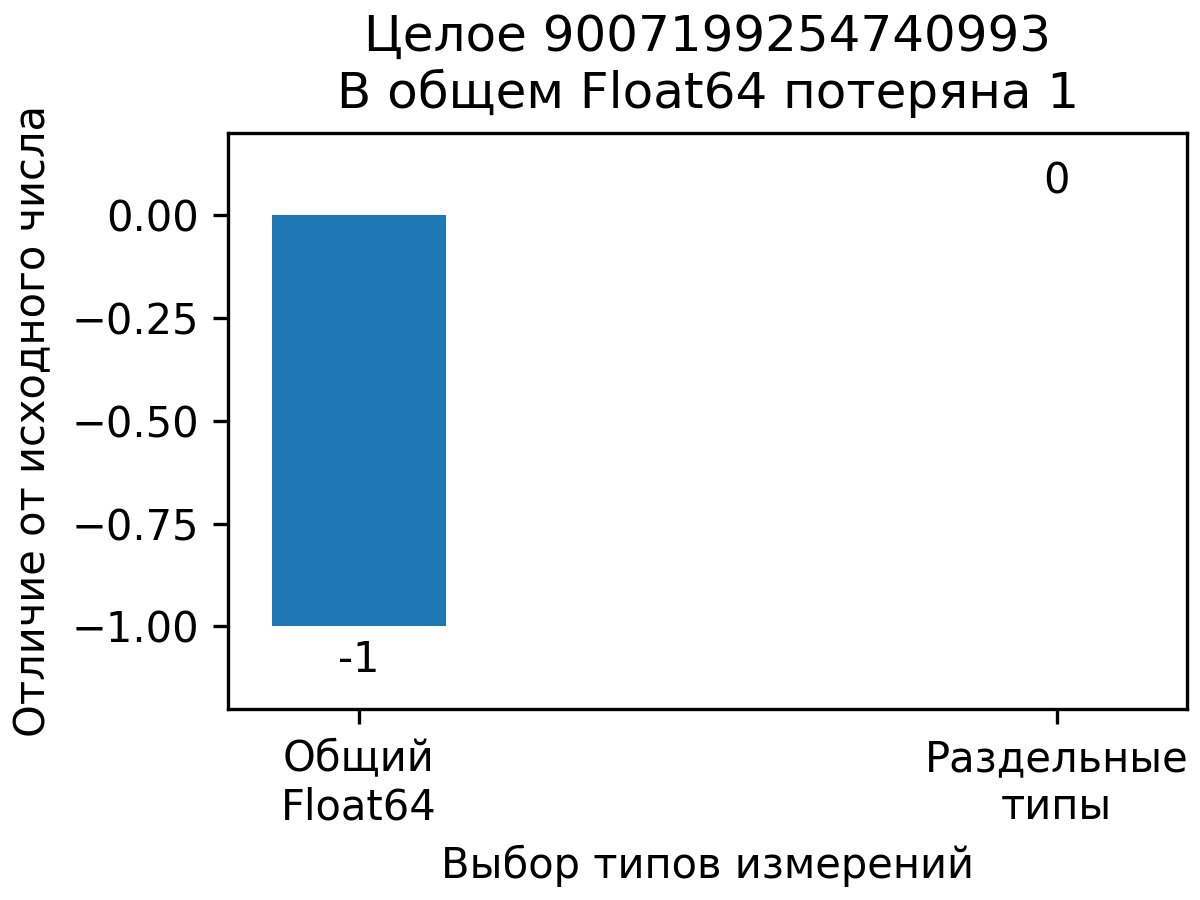
Проверяйте исходное и полученное число способом, который сам не переводит оба значения в приближённый float. В лаборатории сравнили точные целые после извлечения результата и обнаружили разницу −1. Допуск преобразования типов, в том числе правило с названием safe, не подтверждает сохранение каждого значения. Для точного roundtrip мы также явно задали check_exact=True у assert_frame_equal и отдельно убедились, что проверка различает 1.0 и 1.00000001. Допуски сравнения подходят другим задачам, если их величина и смысл заранее согласованы.
Даже два транспонирования не обязательно возвращают схему. В проверенной таблице из целого, дробного и текстового столбца операция .T.T вернула значения на прежние позиции, но типы отличались. Сохранённый до преобразования mapping типов помог восстановить схему этого неповреждённого набора. Он не вернёт единицу, которая уже потерялась при float-преобразовании, или значение, заменённое нулём. Поэтому проверяйте данные до исправления схемы и учитывайте ошибки приведения, вместо того чтобы скрывать их.
Имена колонок и новый месяц тоже требуют правил
Две физические колонки с одинаковым заголовком «январь» могут содержать разные значения. В нашем наборе у a они содержали 10 и 20. melt создал две строки с одним названием измерения; обратный pivot увидел повтор ключа и отказал. До разворота проверьте уникальность имён колонок. Для многоуровневой шапки сохраните полное имя с показателем, периодом и единицей. Механическое добавление номера отличит колонки технически, но не объяснит, что измеряли их значения.
Числовой суффикс может изменить исходное имя. wide_to_long в нашем запуске разобрал x_01 и x_02 как номера 1 и 2 с целочисленным типом, не сохранив ведущие нули. Если суффикс является кодом, а не просто номером, сохраните явное соответствие исходного имени и полученного измерения. Обычный melt с названиями колонок даёт другой способ учесть имена. Но и после него проверьте последующие операции: преобразование названия в число снова может убрать значимые символы.
Автоматический выбор «все колонки, кроме идентификаторов» удобен для новых месяцев, но захватывает и новые атрибуты. В пример добавили третий месяц и поле region. melt, сохраняющий только id и budget, включил region среди измерений и получил восемь строк. Когда region оставили атрибутом, а месяцы выбрали по объявленному правилу имён, получилось шесть строк: два объекта на три месяца. Это конкретная проверка состава колонок, а не доказательство пригодности любого регулярного выражения.
У правила выбора должны быть две стороны: какие новые измерения разрешены и какие неизвестные поля требуют разбирательства. Зафиксируйте список выбранных месячных колонок и список оставленных атрибутов. Если пришёл новый показатель с непривычным именем, не выбрасывайте его молча только потому, что он не подходит шаблону. Сравните исходную схему с разрешённой, покажите нераспознанные поля и измените правило после проверки смысла. При восстановлении используйте сохранённый список, а не сегодняшнюю схему следующей выгрузки.
Что отдельно проверить в Power Query
В документации операции «Сводный столбец» Power Query описана сумма как обычный выбор агрегирования. Для восстановления отдельных значений требуется вариант без агрегирования и однозначная комбинация остальных полей с будущим названием колонки. Например, если один объект имеет данные двух филиалов за один месяц, удаление филиала заранее создаст неоднозначность. Проверьте полный ключ до свёртки. Указание суммы, максимума или другого агрегата разрешает построить сводку, но не сохраняет автоматически сведения о каждой исходной записи.
Политику null проверяйте по используемой операции. В опубликованном примере M-функции Table.Unpivot исходные две строки имеют по три измерения, среди которых два null; результат содержит четыре строки. Эти две пустые ячейки в примере не представлены отдельными строками. Поэтому результат нашего pandas melt с шестью ячейками нельзя переносить на Power Query как общее обещание. Если пустые ячейки или полностью пустые объекты должны восстанавливаться, проверьте это на своей версии и сохраните их присутствие отдельно.
Ошибки преобразования типа требуют отдельного учёта. Сначала найдите строки с ошибками, например через Table.SelectRowsWithErrors по нужным колонкам, и выясните исходное значение и шаг возникновения. Замена ошибки через Table.ReplaceErrorValues превращает её в обычное значение. После такой замены итоговая таблица уже не расскажет, была ли там ошибка чтения, неизвестное значение или настоящий ноль. Сохраните журнал исключений либо отдельный признак причины; устранение красной отметки само по себе не подтверждает корректность данных.
Проверьте также выбор, переименование и перестановку колонок. Политика MissingField.Ignore может позволить шагу пройти при отсутствии ожидаемого поля; MissingField.UseNull создаёт пустое поле вместо недостающего, где такая политика поддерживается. Это полезные явно выбранные действия, но они не возвращают исходное измерение. Сравнение Table.Schema и сохранённого списка полей помогает обнаружить изменение схемы. Затем отдельно проверьте содержимое, присутствие записей и ошибки: описание типов не отвечает на эти вопросы.
SQL: обратная форма не отменяет агрегирование
В SQLite мы собрали широкую таблицу условными суммами по месяцам и развернули её обратно через UNION ALL. До преобразования было четыре события с общей суммой 70; после него тоже получилось четыре строки и сумма 70. Тем не менее два январских события объекта a превратились в одну сумму 40, а для отсутствовавшей пары a/февраль появилась строка с NULL. Два привычных контроля прошли, хотя состав событий изменился. Для восстановления событий нужен их ключ и исходная кратность, а для отсутствовавших пар — сохранённый признак присутствия.
Значение агрегата на пустом наборе тоже зависит от среды и функции. COUNT(*) считает строки, COUNT по колонке — её значения без NULL. В SQLite sum возвращает NULL, если строк нет или все значения равны NULL; отдельная функция total в таком случае возвращает 0.0. В документации PostgreSQL для sum пустого набора также указан NULL. Это отличается от обычного поведения pandas sum с min_count=0. Когда результаты двух этапов сравниваются, согласуйте правила пустого набора и отсутствующих значений, вместо того чтобы автоматически заменять все NULL нулями.
Код следует хранить в подходящем текстовом поле, если значимы его символы. В проверенной обычной таблице SQLite колонка с NUMERIC affinity преобразовала строку «001» в число 1, а «3.0e+5» — в целое 300000. В колонке TEXT обе исходные строки сохранились. Это испытание конкретного способа хранения в SQLite, а не всех баз данных или режима STRICT. Потеря символов произошла уже при записи в таблицу; последующий правильный pivot не сможет узнать исходное написание кода.
Порядок проверки своего файла
- Сохраните оригинал и его схему. Зафиксируйте исходные имена, типы, порядок колонок и строк, число объектов и выбранных измерений. Работайте с отдельным результатом, чтобы сохранилось с чем сравнивать.
- Объявите единицу записи и полный ключ. Проверьте все поля, различающие события: объект, филиал, период, версию или идентификатор операции. Обозначьте, какой ключ будет у ячейки в длинной форме.
- Выберите измерения явно. Отделите их от атрибутов объекта. Покажите неизвестные колонки, проверьте повторяющиеся заголовки и сохраните соответствие имён, если разбираете суффиксы или многоуровневую шапку.
- Сохраните состояния отсутствия. Сосчитайте явные пропуски, нули и ошибки; отдельно запомните присутствие исходных пар, если предстоит заполнение прямоугольника. Не смешивайте эти состояния до предметного решения.
- Проверьте неоднозначные ячейки. Соберите исходные строки каждого повторяющегося ключа. Если нужна агрегация, объявите её смысл и признайте, что результат является сводкой. Если нужны события, сохраните их самостоятельные ключи.
- Сравните результат на требуемом уровне. Для обратимости сопоставьте ключи с их кратностью, точные значения, пропуски и типы; восстановите согласованный порядок. Дополните суммы проверками состава записей и точности больших чисел.
- Остановитесь на первом изменившем данные шаге. Разберите его на небольшом наборе, включающем найденный случай. После исправления повторите затронутую проверку; сохраняйте версии входа и принятого результата, чтобы новая выгрузка не подменяла исходный снимок.
Наши числовые выводы относятся к 21 проверенному случаю на искусственных данных в Python 3.12.14, pandas 3.0.1 и SQLite 3.53.1. Ещё две проверки контролируют строгость сравнения одинаковых и близких дробных значений. Здесь не проверены интерфейсы Excel и Power Query, сторонние коннекторы и все варианты SQL PIVOT. Для другого инструмента используйте тот же договор сохранности данных и короткие собственные примеры; сходное название операции не заменяет испытание.
Результат можно принять, когда он выполняет объявленную задачу: либо точно сохраняет исходные ячейки и записи, либо создаёт понятную сводку с разрешённой потерей подробностей. Само совпадение формы, суммы и числа строк для этого недостаточно. Если восстановление требуется позднее, сохраните оригинал, полные ключи, схему и сведения об отсутствии до первого необратимого шага.