Один набор — разные гистограммы: как проверить выбор интервалов
Один и тот же набор чисел может выглядеть по-разному из-за bins. Показываем проверку ширины, границ, общих интервалов для групп и частоты против плотности.
Если один и тот же набор чисел даёт на экране две разные «формы распределения», первым делом проверьте bins — интервалы, в которые попадают наблюдения. Данные могли остаться прежними, а ширина, начало сетки или правило включения границ изменились. Практический порядок такой: сохранить набор и фильтры, записать границы каждого интервала, посчитать попадания вручную на небольшом примере, сравнить несколько разумных сеток и только затем делать вывод о пике, провале или хвосте.
У гистограммы нет одной сетки, которая была бы правильной для любого вопроса. Сетка — это часть измерения: она определяет, какие наблюдения считаются соседями и насколько грубо вы видите распределение. Поэтому «автоматически выбранное число столбцов» — стартовая настройка, а не доказательство формы. Вывод считается устойчивым, когда он сохраняется при нескольких обоснованных вариантах интервалов и не исчезает после проверки крайних значений.
Сначала зафиксируйте данные, а не внешний вид
Для примера возьмём один набор: 3, 4, 5, 5, 6, 7, 8, 12, 13, 14, 15, 15, 16, 17, 18, 22, 23, 24, 25, 40. Это двадцать наблюдений одной числовой переменной. Между вариантами гистограммы мы не удаляем 40, не меняем фильтр и не округляем значения. Если подгруппа, период или единица измерения меняются, это уже другая причина различий, а не эффект выбора интервалов.
До построения полезно записать минимум: что является одним наблюдением, какой диапазон дат выбран, какие пропуски исключены и в каких единицах измеряется число. Если рядом сравниваются две панели, эти условия должны быть одинаковыми. Проверка масштаба и сопоставимости панелей относится к отдельной задаче; при необходимости свяжите её с материалом об осях и базовых линиях графиков.
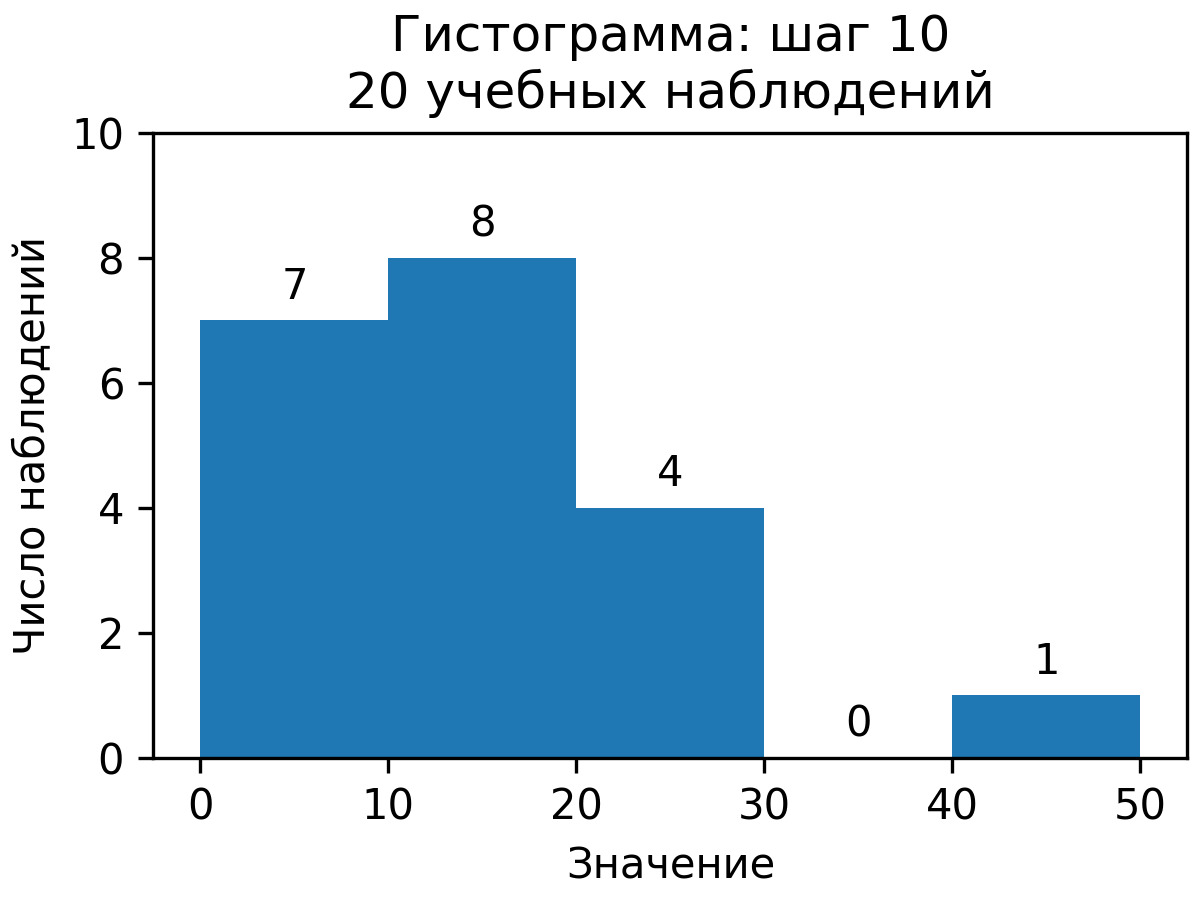
Теперь зададим границы 0, 10, 20, 30, 40 и 50. В обычной записи первые интервалы читаются как [0; 10), [10; 20), [20; 30), [30; 40), а последний — с включённой правой границей, если так задано правилом. Получаются количества 7, 8, 4, 0 и 1. Читатель видит большую группу до 20, меньшую группу от 20 до 30, пустой участок перед 40 и одиночное крайнее значение.
Та же выборка, более мелкая сетка
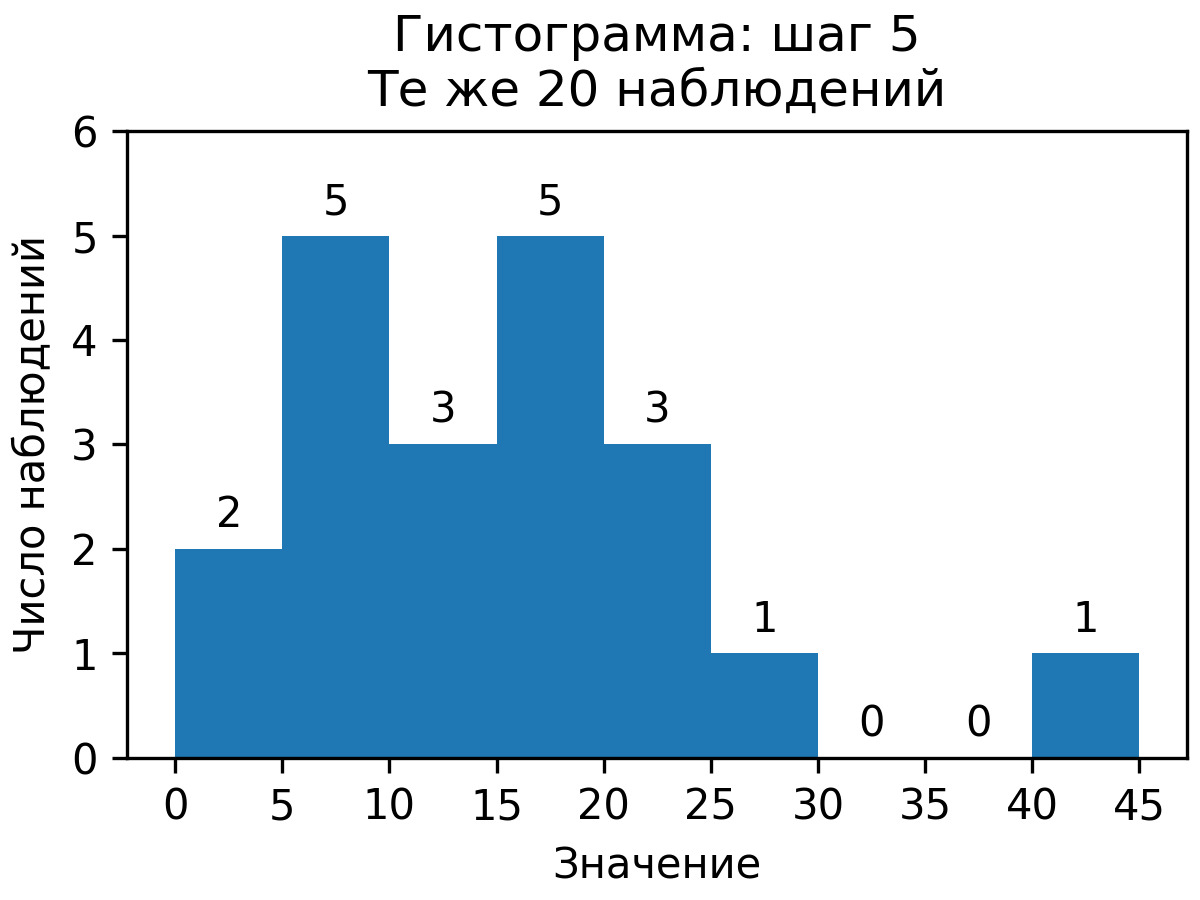
Разобьём тот же набор границами 0, 5, 10, 15, 20, 25, 30, 35, 40 и 45. Счётчики для полуинтервалов равны 2, 5, 3, 5, 3, 1, 0, 0, 1. Теперь внутри прежних столбцов видны локальные провалы и подъёмы: значения 5, 15 и 25 оказываются по разные стороны соседних границ, а хвост из 40 занимает отдельный маленький столбец. Форма стала подробнее, хотя исходный список не изменился.
Это не означает, что мелкая сетка «честнее». При двадцати наблюдениях один элемент заметно меняет высоту узкого столбца. Мелкая сетка помогает увидеть возможные кластеры и крайние точки, но легко создаёт зрительный шум. Крупная сетка устойчивее к единичному значению, зато может скрыть два соседних скопления. Выбор зависит от вопроса и размера подтверждаемого эффекта.
Полезный контроль — не выбирать вариант по красивой картинке. Сначала сформулируйте, что именно хотите проверить: есть ли хвост, различаются ли две группы в одном диапазоне, где находятся типичные значения или сохраняется ли провал. Затем выберите две-три сетки, которые отвечают этому вопросу, и вынесите счётчики или границы в подпись, таблицу или рабочую заметку.
Четыре решения, которые меняют bins
Ширина. При фиксированной ширине каждый шаг на оси покрывает один и тот же числовой диапазон. Увеличение ширины объединяет соседние значения и сглаживает локальные детали; уменьшение создаёт больше возможностей для пустых и одиночных столбцов. Ширина должна быть осмысленной в единицах показателя, а не только удобной для заполнения места.
Число интервалов. Иногда программа принимает число bins и сама вычисляет границы. Это не то же самое, что вручную заданная ширина: итог может зависеть от диапазона, округления и реализации. Для воспроизводимости храните сам набор границ или правило, его вернувшее, а не только число «10» в настройке.
Начало сетки. Две сетки одинаковой ширины могут быть сдвинуты. Если пик лежит рядом с границей, небольшой сдвиг переносит несколько значений в соседний столбец. Поэтому при сравнении следует проверить сетку с разумным началом: например, от нуля для шкалы, где ноль имеет смысл, или от заранее согласованного нижнего предела. Нельзя выбирать начало только после просмотра результата, если затем выдаёте его за нейтральный факт.
Границы. Запись [a; b) означает, что левый край включён, а правый исключён. Тогда 10 попадает в следующий интервал, а не в [0; 10). Последний интервал часто закрывают справа, чтобы максимум не оказался за пределами. В разных инструментах одинаковые слова «bins» или «верхняя граница» могут скрывать разные контракты, поэтому крайние значения нужно проверить отдельной строкой.
В документации NumPy внутренние интервалы histogram описаны как левозамкнутые и правораскрытые, а последний включает правую границу. Документация Matplotlib передаёт в hist либо число, либо последовательность границ и возвращает сами edges вместе со счётчиками. Это полезная модель для воспроизводимой проверки: сравнивайте не только картинку, но и массив границ, counts и обработку значений вне диапазона.
Минимальная запись эксперимента: данные или их хеш, число наблюдений, фильтры, границы bins, правило включения краёв, способ нормировки и дата построения. Без этой записи смену формы легко принять за изменение данных.
Автоматические правила дают кандидата, а не вердикт
В статистических и программных библиотеках встречаются правила Sturges, Scott, Freedman–Diaconis и их комбинации. Они используют размер выборки, разброс или межквартильный размах, чтобы предложить число или ширину интервалов. Это полезная отправная точка, когда заранее нет предметной шкалы, но результат всё равно нужно осмотреть на исходных значениях и в единицах задачи.
На маленькой выборке оценка ширины нестабильна: добавление или удаление одного наблюдения может изменить диапазон и число bins. При повторяющихся значениях межквартильный размах может быть очень малым или нулевым, а при длинном хвосте несколько экстремальных точек растягивают диапазон. Автоматическое правило не знает, что для бизнеса разница в один пункт неотличима от шума, и не знает, что ноль имеет отдельный смысл.
Разумная проверка состоит из трёх слоёв. Первый — предметная сетка, например шаг, который читатель может объяснить в единицах показателя. Второй — кандидат автоматического правила. Третий — соседняя сетка с немного большей или меньшей шириной. Если вывод сохраняется во всех трёх, доверие к нему выше. Если меняется, это результат чувствительности, который нужно показать, а не скрыть выбором одного варианта.
Особенно осторожно относитесь к выбросам. Один максимум может создать большой последний интервал, заполненный единственным наблюдением, и визуально сжать основную массу. Полезно построить дополнительный график с тем же правилом на полном диапазоне и отдельно проверить хвост. Нельзя молча обрезать экстремум: если его исключение допустимо, укажите критерий и покажите, сколько строк затронуто.
Как сравнивать две группы
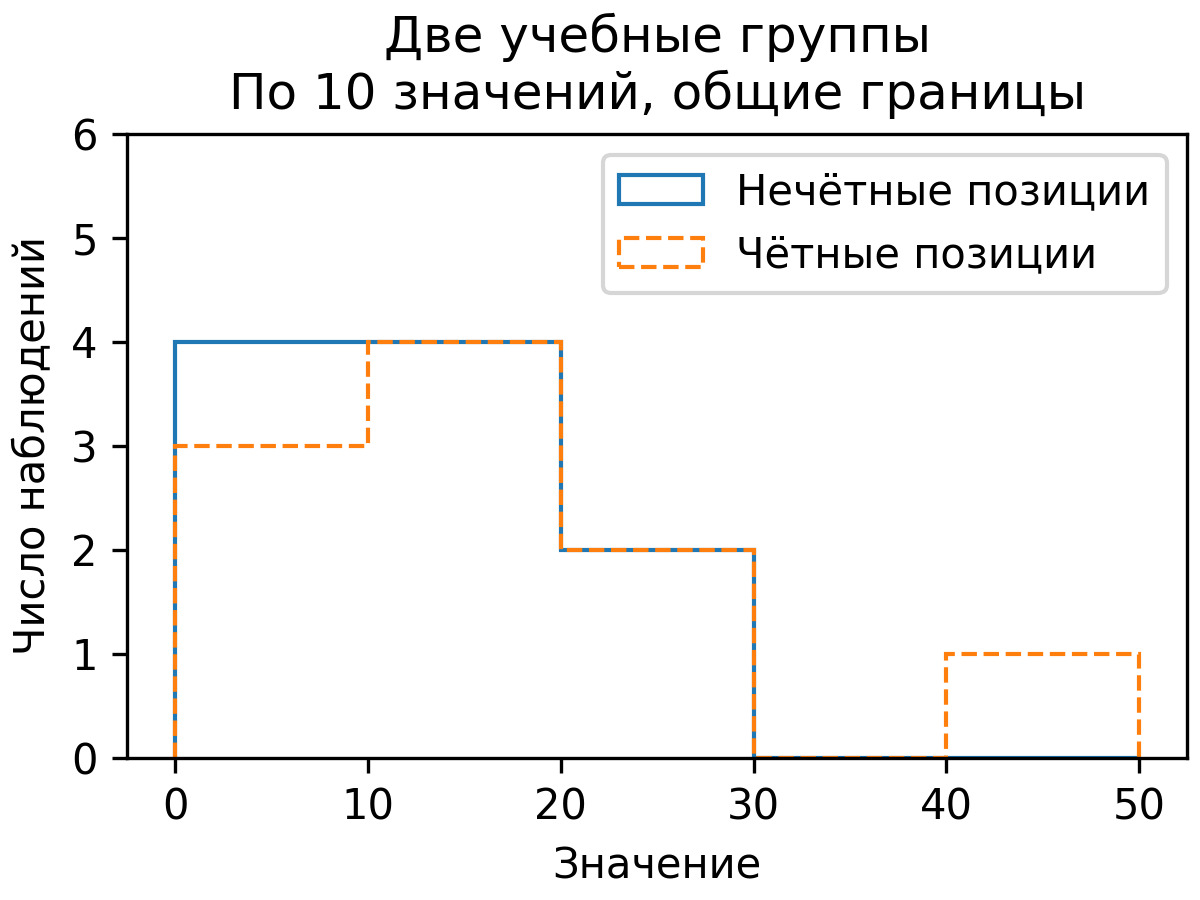
Для двух групп первая обязательная договорённость — одна сетка границ. Если программа подбирает bins отдельно для каждой группы, одинаковая высота может означать разные числовые диапазоны. Такой рисунок годится для отдельного описания каждой выборки, но не для прямого сравнения столбцов.
Есть два прозрачных способа получить общую сетку. Можно заранее задать предметные границы, например шаги 0–10, 10–20 и так далее. Можно вычислить границы один раз по объединённому диапазону или согласованному эталону и передать этот массив обеим группам. В обоих случаях сохраните правило, диапазон и решение о значениях ниже минимума или выше максимума.
После этого проверьте одинаковость остальных условий: переменная, единицы, период, фильтры, пропуски и число наблюдений. Если одна группа содержит вдвое больше строк, её абсолютные counts могут быть выше даже при одинаковой доле. Поэтому рядом с высотой столбцов укажите размер группы и заранее выберите, нужен ли count, доля от своей группы или другой показатель.
Сравнивать цвета в наложенных гистограммах тоже нужно осторожно. Прозрачность и порядок слоёв могут скрыть столбец, но это уже проблема отображения, а не bins. Для проверки вынесите группы в отдельные панели с одинаковыми осями и границами, а затем вернитесь к компактному виду для читателя. Так визуальный дизайн не подменяет числовую сверку.
Частота, доля и плотность — разные высоты
Если высота равна count, столбец показывает число наблюдений. Если высота равна count, делённому на размер группы, это доля внутри выбранной выборки. Эти варианты отвечают на вопрос «сколько» и «какая часть» и зависят от того, что вы приняли за знаменатель.
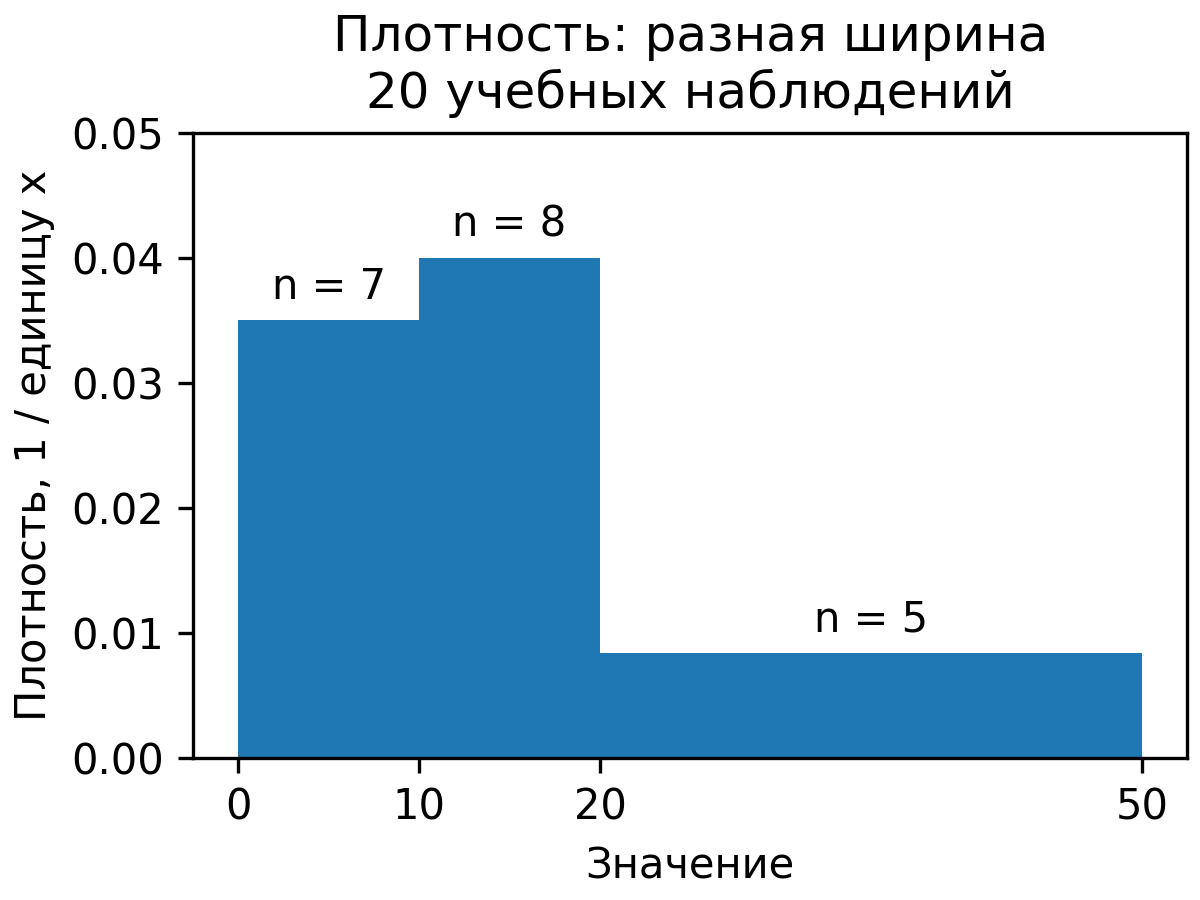
При равной ширине bins форма долей часто выглядит похоже на форму counts, поэтому различие остаётся незаметным. При неравной ширине так делать нельзя. Широкий интервал может собрать больше значений за счёт большего охвата шкалы; это ещё не означает большей концентрации наблюдений. Для плотности используют величину, пропорциональную count / (размер выборки × ширина интервала). Тогда смысл имеет площадь прямоугольника, а не одна его высота; сумма площадей соответствует единице с учётом округления.
Из этого следуют две проверки. Во-первых, прочитайте подпись оси y и настройку нормировки, а не угадывайте её по внешнему виду. Во-вторых, если bins неодинаковы, сравнивайте площади или явно сообщайте, что показываются counts. Высота плотности может быть больше единицы на узком интервале и от этого не становится ошибкой: она измеряется «на единицу шкалы».
Для сравнения групп при density знаменатель и границы должны быть согласованы. Если нормировать каждую группу на её собственное число наблюдений, вы сравниваете формы внутри групп. Если нужен вклад в общий поток, может быть уместна общая база, но это уже другой вопрос. Нормировку нельзя выбирать после просмотра нужной разницы.
Граничные значения и сверка с таблицей
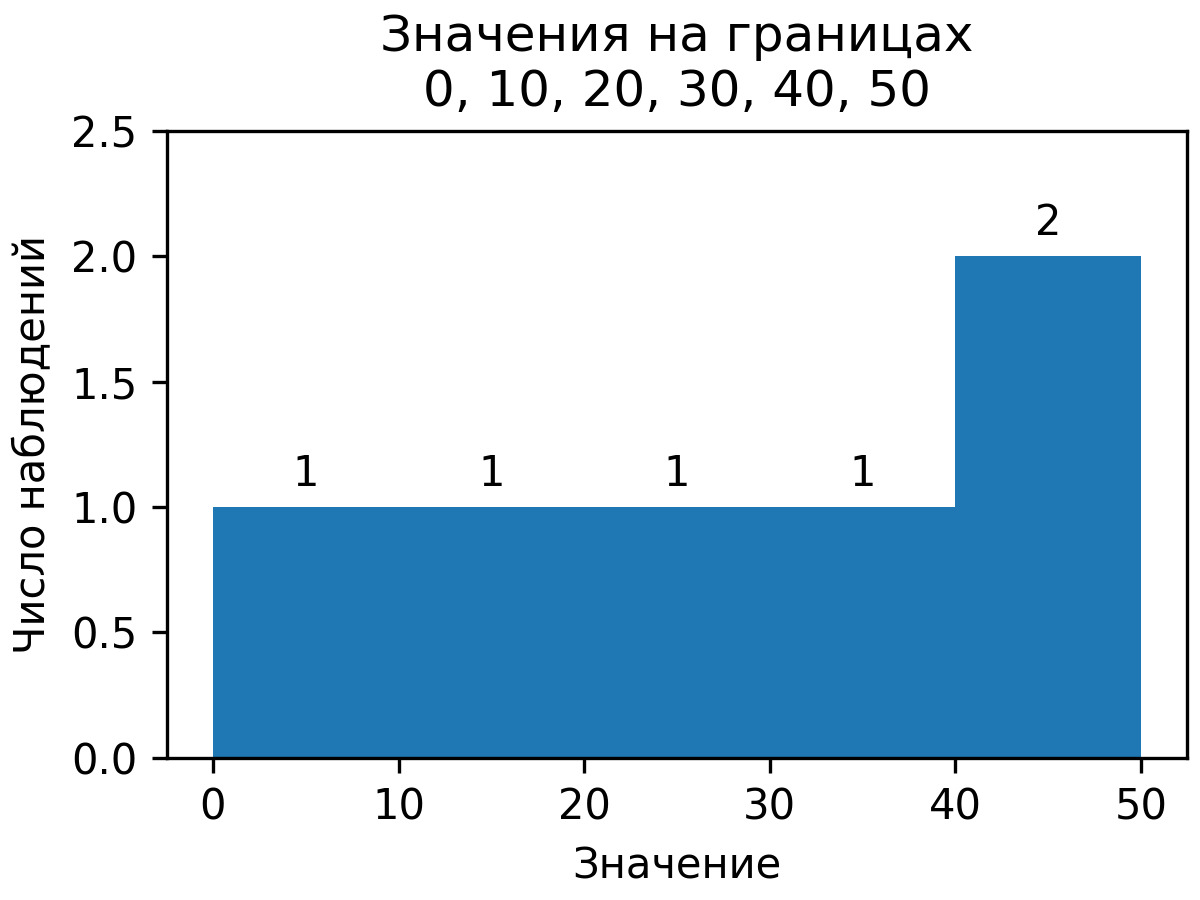
На маленьком наборе границы проще всего проверить отдельной таблицей. Для каждой строки запишите значение, номер bins и причину попадания. В нашем примере при [0; 10) число 10 не попадает в первый интервал, а 8 попадает. Значения 20 и 30 переходят в интервалы, начинающиеся с этих чисел, если используется левое включение. В сетке с границами 0, 10, 20, 30, 40 и 50 число 40 входит в последний интервал по его левой границе: закрытие справа влияет на число 50. Если сетка заканчивается на 40, NumPy включает число 40 в последний интервал [30; 40].
Такой список помогает заметить сразу несколько ошибок: перепутанную единицу измерения, ошибочный нижний предел, значение за range, различие между пропуском и нулём или двойной подсчёт на общей границе. В SQL аналогичная проверка часто выражается CASE или функцией bucket; в Python и R есть свои функции поиска интервала. Название параметра не заменяет чтение контракта конкретной версии.
В Excel и других табличных инструментах верхние пределы bins могут быть представлены как список порогов. Это удобный интерфейс, но он может отличаться от явного массива полуинтервалов в библиотеке. Поэтому перенос результата между программами проверяйте на значениях ровно на границе: минимум, каждый порог, максимум и два значения по обе стороны. Числовые примеры в этой статье проверены в NumPy 2.3.5; интерфейсы Excel, Power Query и Calc мы не проверяли.
Когда добавить точки, ECDF или сглаживание
Точки наблюдений или rug-полоска полезны, когда нужно увидеть, не создан ли столбец несколькими значениями. Они дополняют histogram, но не заменяют выбор bins. При двадцати строках лучше показать отдельные точки, чем заставлять читателя угадывать, сколько наблюдений спрятано в высоте.
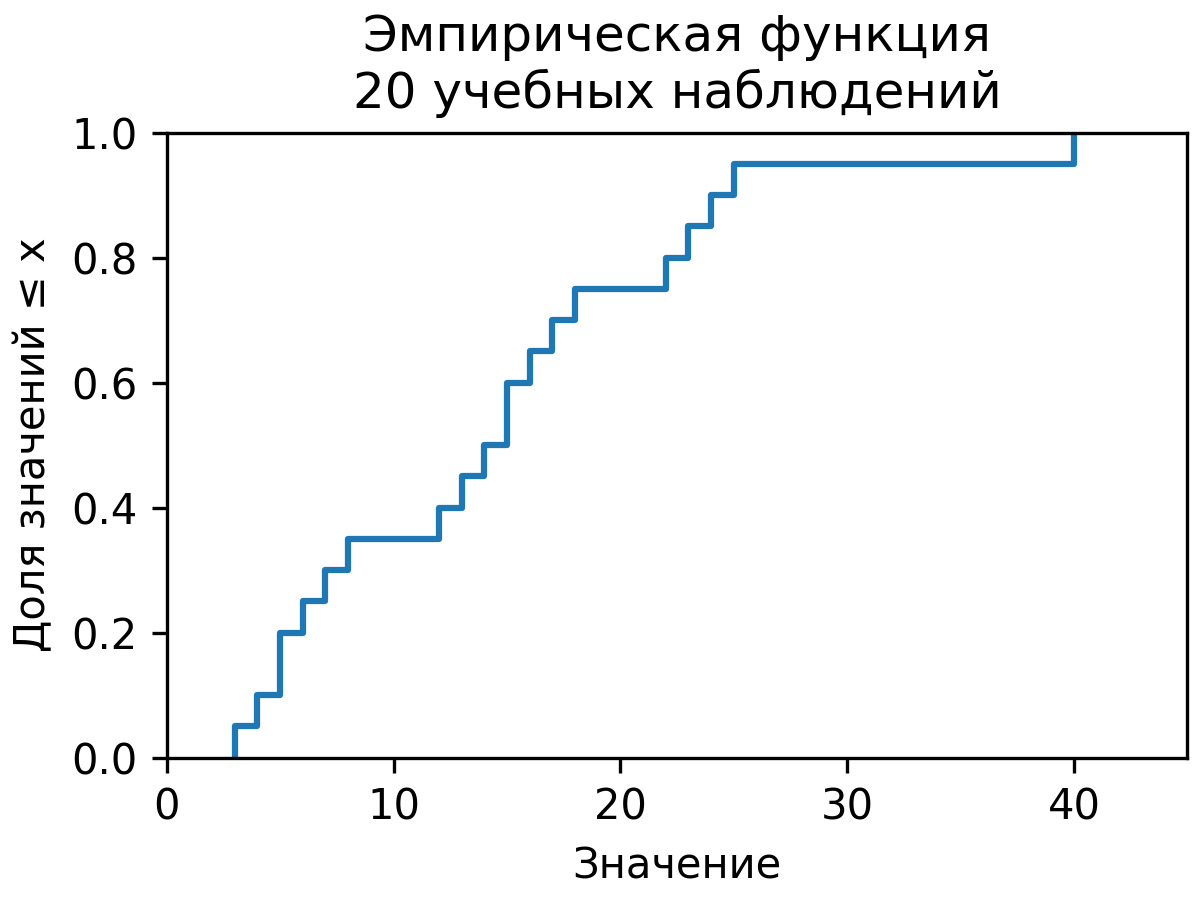
Эмпирическая функция распределения, или ECDF, показывает долю наблюдений, не превышающих каждое значение. У неё нет сетки равной ширины, поэтому она помогает проверить, не исчезает ли порядок групп из-за bins. Но ECDF отвечает на другой вопрос: как накапливается доля, а не сколько значений лежит в каждом числовом диапазоне.
Сглаженная оценка плотности также не является «более настоящей гистограммой». Она зависит от ширины окна и другой модели сглаживания. На маленькой выборке или при нескольких повторяющихся значениях сглаженная линия может выглядеть убедительно и скрыть дискретность. Используйте её как дополнительную гипотезу, подписывайте настройки и сопоставляйте с исходными точками.
Если после этих проверок читателю нужно одно числовое описание центра и разброса, не подменяйте им распределение. Среднее, медиана и разброс отвечают на иные вопросы; переход к ним после графика можно связать со статьёй о среднем, медиане и разбросе.
Как выбрать стартовую сетку по вопросу
Если задача связана с нормативными порогами, начинайте с границ, которые читатель уже понимает: диапазоны возраста, интервалы времени, шаг шкалы прибора или рабочие категории, согласованные в методике. Такая сетка может быть не оптимальной для оценки плотности, зато её смысл прозрачен и одинаков для разных отчётов. Рядом можно показать автоматический вариант как проверку чувствительности, но не смешивать две интерпретации в одном выводе.
Если порога заранее нет, сначала определите разумный диапазон просмотра. Не позволяйте нескольким крайним значениям автоматически занять большую часть оси, если вопрос относится к основной массе. При этом полная гистограмма должна сохранять хвост, а решение о дополнительном крупномасштабном кадре нужно записать. Обрезанная ось без объяснения создаёт ложное ощущение, что крайних значений не существует.
Шаг должен быть соразмерен точности исходных данных. Для измерения, округлённого до целых единиц, сетка с множеством десятичных границ создаёт видимость точности, которой нет в источнике. Для непрерывного измерения слишком крупный шаг, наоборот, скроет полезное различие. Спросите себя, сможет ли другой человек по записи границ повторить распределение без догадки о скрытом округлении.
Для повторяющегося отчёта полезно разделить «сетку по умолчанию» и «сетку для диагностики». Первая остаётся стабильной между периодами, чтобы изменения высот имели смысл. Вторая может быть мельче и использоваться для поиска локальных скоплений, пустых зон и проблемных значений. Нельзя сравнивать месяц к месяцу графики, если сетка каждый раз подстроена под новый минимум и максимум, а затем приписывать разницу данным.
Что записать в отчёте рядом с графиком
Короткая подпись должна отвечать на пять вопросов: сколько наблюдений вошло, какая переменная измеряется, какие границы использованы, что означает высота и какие фильтры применены. Если ширина интервалов различается, добавьте это прямо в подпись и назовите нормировку. Если показаны две группы, укажите, что границы общие, и приведите размер каждой группы.
Рабочий журнал может хранить более подробную таблицу: список edges, counts по каждому bins, число значений вне диапазона, число пропусков, версию библиотеки или табличного инструмента и дату. Для динамического отчёта стоит также записать, кто задал диапазон и что произойдёт при новом максимуме. Это дешевле, чем восстанавливать причину смены формы после публикации.
Когда выбор сетки является частью исследовательского решения, сохраните несколько вариантов рядом с итоговым. Не обязательно перегружать читателя всеми техническими графиками: достаточно дать ссылку на методику или коротко описать проверку. Но редактор и автор должны видеть, что итоговый тезис не появился из единственной случайной комбинации границ.
Короткий протокол перед выводом
- Сохраните исходный набор, число строк, фильтры, единицы и правило обработки пропусков.
- Запишите конкретные границы bins и правило включения левого и правого края.
- Проверьте вручную минимум, максимум, каждый порог, соседние значения и строки вне диапазона.
- Постройте предметную сетку, автоматический кандидат и соседнюю по ширине сетку на тех же данных.
- Для групп передайте один и тот же массив границ, общий диапазон и одинаковую переменную.
- Подпишите count, долю или density; при разной ширине читайте плотность по площади.
- При чувствительном выводе добавьте точки или ECDF и покажите, что именно изменилось.
Финальный вывод должен содержать не только слова «распределение бимодальное» или «у группы длинный хвост», но и условия, при которых это видно. Напишите сетку, размер выборки, нормировку и результат проверки соседних вариантов. Если форма исчезает при небольшом сдвиге границ, честнее сказать, что данных недостаточно для устойчивого вывода, чем превращать конкретную настройку в свойство набора.
Интервалы — это измерительный инструмент, а не декоративная настройка. Они не исправляют неверные данные, смешанные единицы, пропуски, ошибочный период или слишком маленькую выборку. Они также не создают причинного объяснения пика. Их задача скромнее и полезнее: сделать явным правило группировки, дать сравнимую основу и показать, насколько вывод зависит от выбранного разрешения.