100% на диаграмме: как не скрыть размер сравниваемых групп
Как читать нормированную диаграмму: сравниваем доли и количества, подписываем размер групп, учитываем пропуски, несколько ответов, округление и веса на проверенных учебных примерах.
Две полосы, заполненные на 60%, могут означать 30 ответов из 50 и 600 из 1 000. Нормированная диаграмма показывает одинаковую долю, но скрывает двадцатикратную разницу в количестве. Чтобы читатель не принял равную длину за равный объём данных, подпишите размер каждой группы и объясните, кого включили в расчёт. Если решение зависит от числа людей, заявок или товаров, покажите рядом сами количества.
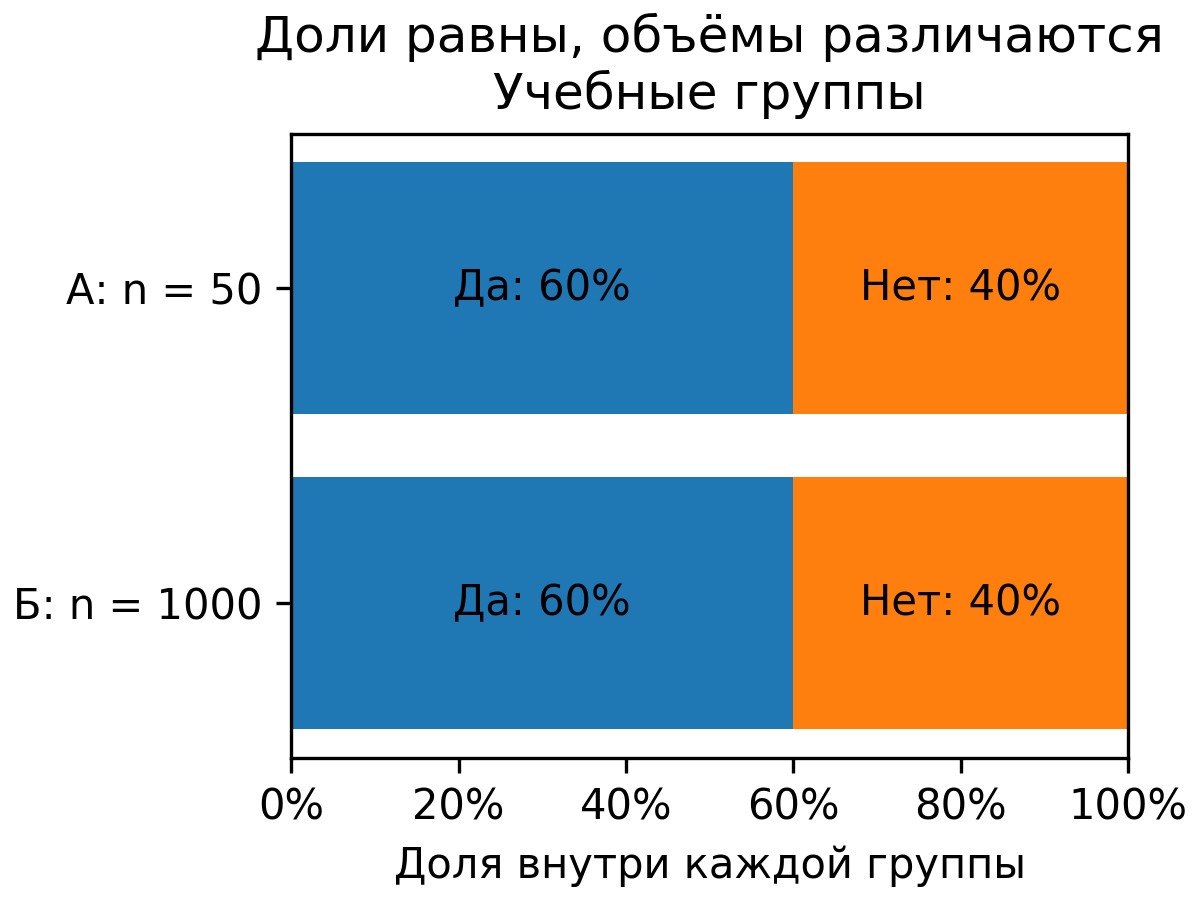
Ниже — учебные наборы, придуманные для проверки расчётов. Это не результаты опроса и не сведения о реальных организациях. На них разберём, когда 100% означает всю группу, когда только ответивших и почему иногда сумма долей законно превышает сто. Все значения из рисунков повторены в тексте: прочитать пример можно и без изображения.
Что делает нормирование до 100%
В обычной диаграмме с накоплением длины частей соответствуют количествам. В нормированной каждая часть делится на общий размер своей группы. Для взаимоисключающих категорий, которые вместе покрывают группу, получается полоса одинаковой полной длины — 100%. Такой вид удобен для вопроса «как устроена каждая группа», но сам по себе не отвечает на вопрос «сколько наблюдений за этой структурой».
Возьмём группу А: 30 человек ответили «да», 20 — «нет», всего 50. В группе Б — 600 ответов «да», 400 ответов «нет», всего 1 000. Доля «да» равна 30 / 50 × 100% = 60% и 600 / 1 000 × 100% = 60%. Для «нет» в обоих случаях получаются 40%. Нормированные полосы совпадут, хотя исходные числа различаются.
Подписи «А: n = 50» и «Б: n = 1 000» возвращают читателю утраченную информацию. Здесь n — число участников соответствующей учебной группы. Если в исходной таблице были бы покупки, n могло бы означать число покупок. Буква не задаёт единицу наблюдения: её нужно назвать словами. Подпись «n = 1 000» без пояснения не позволяет отличить тысячу покупателей от тысячи заказов.
Равные 60% — точное описание этих двух наборов. Из него нельзя заключить, что группы одинаковы во всём, что ответы имеют одинаковую точность или что так же ответило бы население. Нормирование меняет масштаб рисунка, а не качество исходных данных. Поэтому размер группы и условия сбора данных дополняют процент, но не превращают его в доказательство более широкого вывода.
Когда рядом нужны количества
Представьте, что по ответам нужно подготовить материалы для каждого выбравшего «да». Для группы А понадобится 30 комплектов, для группы Б — 600. Процентная диаграмма не поможет оценить эту нагрузку без дополнительных чисел. Отдельные полосы количеств на общей шкале сразу показывают разницу в двадцать раз. Подписи n остаются полезны: 600 ответов получены из гораздо большей группы.
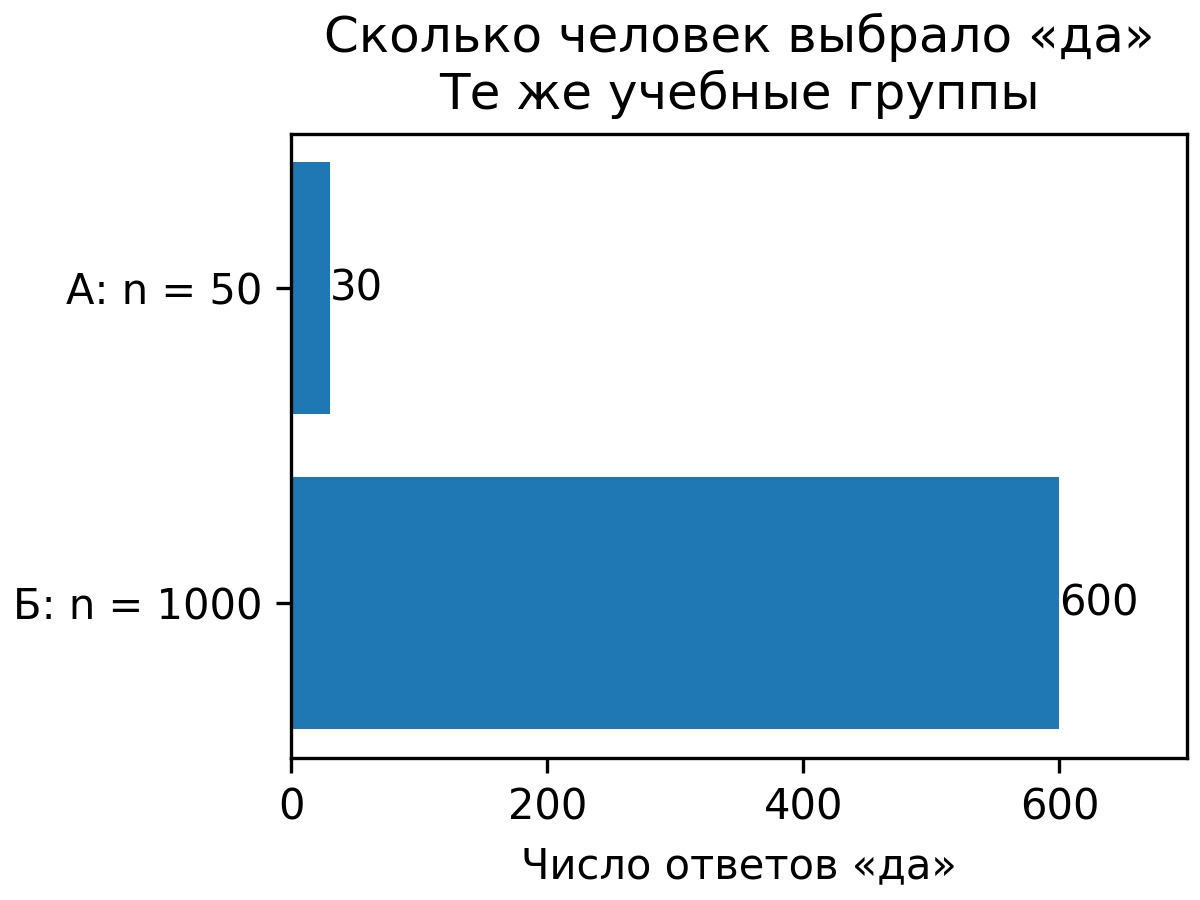
Не обязательно помещать все представления в один рисунок. Если главный вопрос касается состава, оставьте нормированную диаграмму и укажите рядом количества. Если вопрос касается объёма работы, главным графиком сделайте числа. Когда нужны оба ответа, два небольших графика с одинаковым порядком групп обычно проще прочитать, чем одну диаграмму с дополнительной осью и несколькими видами подписей.
Не меняйте ширину нормированных полос произвольно, пытаясь намекнуть на размер групп. Читатель может принять площадь за ещё один показатель, хотя правило нигде не объяснено. Для данного примера достаточно явных n и отдельного сравнения 30 с 600. Более сложное представление требует собственного объяснения и проверки, что по нему действительно можно извлечь нужные значения.
Если сравниваете только долю одной категории, например «да», отдельные полосы процентов могут оказаться удобнее накопления. Все они начинаются в одном месте. У внутренних сегментов составной полосы такой общей точки отсчёта нет, и небольшую разницу сравнить труднее. Цвет также не должен быть единственным способом понять категорию: используйте подписи, сохраняйте их порядок и поясняйте значения.
Размер группы считается для конкретного вопроса
Число участников всего исследования не всегда равно базе отдельной диаграммы. Вопрос могли задать только покупателям определённого товара; часть людей пропустила его; фильтр отчёта мог оставить один регион. Если показать общий размер опроса возле процента небольшой подгруппы, подпись будет формально настоящей, но относиться к другому расчёту. Сверять нужно числитель и знаменатель именно выбранного показателя.
Перед построением запишите одну фразу: «Это доля таких-то наблюдений среди таких-то наблюдений за такой-то период». Например: «Доля заявок с подтверждённым ответом среди всех заявок, поступивших за неделю». Затем проверьте, совпадают ли единица, период и правила отбора в обеих частях. Ответы за неделю, поделённые на заявки за месяц, не становятся недельной долей из-за подходящего заголовка.
Отдельная ловушка — считать строки вместо людей. Один участник может занимать несколько строк после выгрузки ответов или объединения таблиц. Подсчёт строк тогда увеличит n. Определите, что различает участника и отдельное событие; при необходимости используйте число различных идентификаторов с оговорённой обработкой пропусков. Подробно выбор единицы и ключа разобран в статье о подготовке таблицы к анализу.
Сравнимость означает одинаковый смысл показателя, а не одинаковое число записей. Группы из 50 и 1 000 наблюдений могут быть сопоставлены по структуре, если правила расчёта совпадают. И наоборот, две группы по 500 строк могут описывать разные вещи. Например, в одной строка означает человека, а в другой — обращение; одинаковое n этого расхождения не исправляет.
Пропуски меняют знаменатель
Добавим к первой группе десять человек без ответа. Теперь в наборе 60 участников: 30 ответили «да», 20 — «нет», у 10 ответ неизвестен. Если вопрос звучит «какая доля всех участников подтвердила “да”», ответ равен 30 / 60 = 50%. Если нужен состав полученных ответов, база равна 50 и доля «да» составляет 30 / 50 = 60%.
Оба расчёта могут быть полезны, но они отвечают на разные вопросы. Надписи «среди всех 60 участников» и «среди 50 ответивших» обязательны. Разница между 50% и 60% равна десяти процентным пунктам; здесь она возникла только из-за выбора базы. Называть её ростом интереса или изменением мнений нельзя: люди, ответы и момент наблюдения в примере остались прежними.
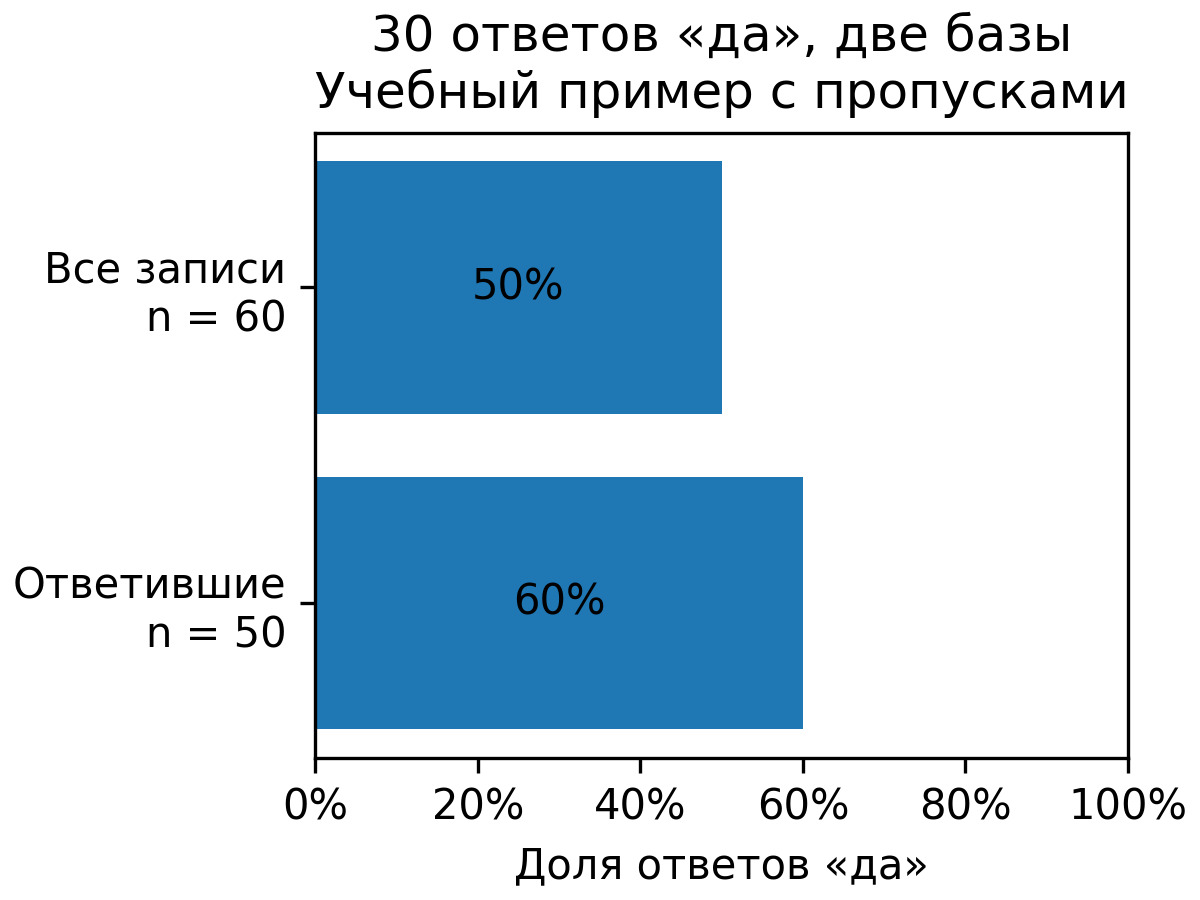
Для представления всех участников возможны три части: «да» — 50%, «нет» — примерно 33,3%, «ответ неизвестен» — примерно 16,7%. Такая полоса показывает и состав, и долю пропусков. Если отображать только ответивших, получится 60% и 40%, а десять пропусков нужно назвать отдельно. Иначе одинаково аккуратная полоса до 100% скроет различие в полноте данных.
Неизвестный ответ не следует переименовывать в «нет». Человек мог отказаться отвечать, не увидеть вопрос или не попасть в его область применения. Эти причины также не всегда стоит объединять между собой. В рабочем отчёте сохраните исходные коды и явно решите, какие из них входят в базу. Автоматическое исключение пустой ячейки программой ещё не означает правильного предметного решения.
При этом показатель «подтверждённые “да” среди всех участников» законен, если именно он нужен. В нём десять неизвестных остаются в знаменателе, но не превращаются в отрицательные ответы. Разница выражается словами в заголовке и подписи. Если читателю нужно понять возможное мнение неответивших, этих данных недостаточно; перенести на них доли ответивших без дополнительных предпосылок нельзя.
Ноль и отсутствие базы — разные состояния
Если из 20 участников никто не выбрал «да», доля равна 0 / 20 = 0%. Это наблюдаемый нулевой числитель при известной ненулевой базе. Если после фильтра участников вообще нет, получается 0 / 0. Такая доля не определена. Покажите «нет данных» или «нет наблюдений для выбранных условий», а не полосу с подписью 0%.
Разница влияет на вывод. Ноль процентов сообщает, что среди учтённых наблюдений выбранного события не было. Отсутствие базы сообщает, что показатель вычислить не из чего. Замена любой ошибки деления нулём в таблице способна смешать эти состояния. Проверяйте знаменатель отдельно; другие ошибки формулы также не нужно маскировать тем же нулём, иначе сломанная ссылка будет выглядеть как результат.
У пустой группы сохраните место или понятное текстовое пояснение, если её наличие важно для сравнения. Простое исчезновение строки может создать впечатление, что такого региона или периода не предусмотрено. Способ обозначения зависит от отчёта, но смысл должен оставаться однозначным. Заполнить недостающую полосу средним соседних групп без отдельного метода оценки тоже нельзя.
Несколько ответов на человека не складываются в состав группы
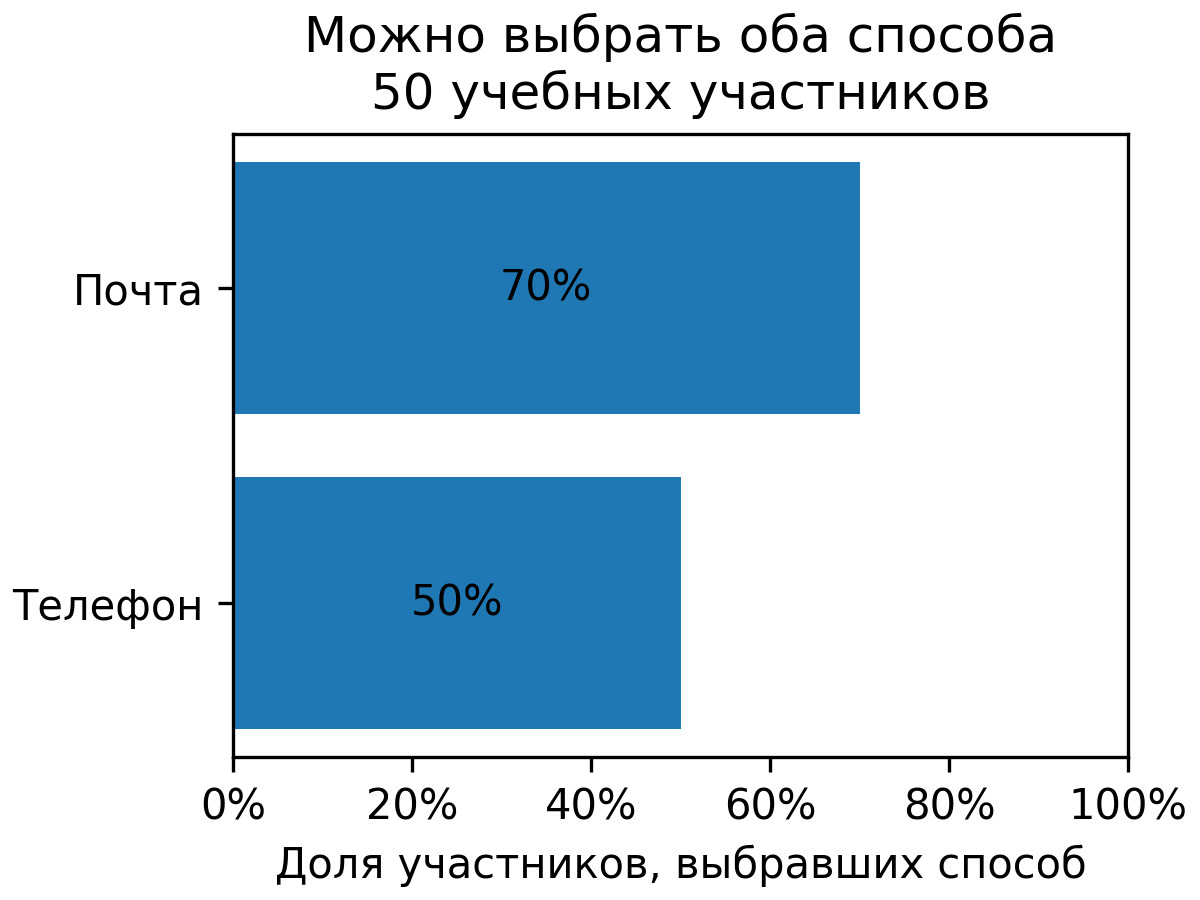
Пусть 50 участников могли выбрать почту, телефон или оба способа связи. Только почту выбрали 25 человек, только телефон — 15, оба способа — 10. Тогда почту отметили 35 участников, телефон — 25. Доли от всех людей составляют 35 / 50 = 70% и 25 / 50 = 50%. Их сумма 120% не является ошибкой: десять человек входят в обе категории.
Для таких данных подойдут отдельные полосы с общей базой n = 50 и пояснением «можно было выбрать несколько вариантов». Нормированная полоса из почты и телефона создаст ложное впечатление, что категории делят людей без пересечения. Даже если программа разрешает построить её одним нажатием, выбранный тип диаграммы не проверяет смысл исходных ответов.
Можно посчитать доли упоминаний: всего выбранных способов 35 + 25 = 60, из них примерно 58,3% относятся к почте и 41,7% — к телефону. Эти доли складываются в 100%, но единицей теперь стал выбранный вариант, а не человек. Такой расчёт допустим для вопроса о структуре упоминаний; он не позволяет утверждать, что почту выбрали 58,3% участников.
Если нужен именно состав людей, используйте непересекающиеся категории: «только почта» — 50%, «только телефон» — 30%, «оба способа» — 20%. Здесь каждый человек попадает ровно в одну часть. Для множества вариантов число комбинаций быстро растёт, поэтому такое решение не всегда удобно. Иногда отдельные доли каждого ответа дают более ясную картину без попытки непременно получить сто процентов.
Проверьте, что именно делит программа
Похожая надпись «процент от итога» может означать итог строки, столбца или всей таблицы. В сводной таблице с группами по строкам и ответами по столбцам для состава каждой группы нужен её собственный итог. Если выбрать общий итог таблицы, получится распределение всех наблюдений между ячейками. Это другой показатель, даже когда названия категорий и исходные количества остались прежними.
Проверка занимает одну строку расчёта. Найдите ячейку, где известны число ответов и база группы; разделите первое на второе вручную. Затем сравните с подписью на диаграмме. В нашем примере для А должно получиться 30 / 50 = 60%. Если программа показывает долю от общего числа 1 050 участников двух групп, искать ошибку нужно в области нормирования, а не в округлении.
В интерактивном отчёте повторите проверку после одного осмысленного фильтра. Отбор обычно меняет доступные данные, но выделение цветом может только подсветить часть прежней полосы. Кроме того, вычисление показателя и применение фильтра могут происходить в разном порядке. Поэтому нельзя заранее считать, что любая кнопка пересчитала знаменатель. Посмотрите на исходное количество, итог и фактический процент после действия.
Сохраните небольшой проверочный набор, в котором базы заведомо различаются: например, те же 50 и 1 000. На равных по размеру группах ошибка выбора общего итога иногда менее заметна. Добавьте случай с пропуском и пустую группу, если они встречаются в отчёте. Проверка должна подтверждать ожидаемый смысл показателя, а не только отсутствие предупреждений программы.
Почему округлённые доли дают 99,9% или 100,1%
Три равные категории имеют точные доли по одной трети. При округлении каждой до одного знака после запятой подписи будут 33,3%, 33,3% и 33,3% — всего 99,9%. Другой пример: из шести наблюдений по одному относятся к первым двум категориям, четыре — к третьей. Подписи 16,7%, 16,7% и 66,7% дадут 100,1%, хотя все шесть наблюдений учтены ровно один раз.
Стройте геометрию по исходным числам или неокруглённым долям, а округляйте отображаемые подписи. Тогда полоса сохранит правильный полный размер. Краткого пояснения «сумма подписей может отличаться от 100% из-за округления» обычно достаточно. Не прибавляйте последней категории десятую долю процента молча только ради красивого итога: подпись перестанет соответствовать тому же правилу, что остальные.
Если для конкретной публикации требуется точная сумма округлённых значений, применяйте заранее выбранное и раскрытое правило согласованного округления. Это отдельное решение. Оно не лечит пропущенную категорию, двойной учёт или неверный знаменатель. Сначала проверьте сумму исходных количеств, а уже затем объясняйте небольшое расхождение оформлением; разницу в десятки процентов округление одного знака не оправдывает.
Взвешенный процент нельзя превращать обратно в число людей
В исследованиях доли могут рассчитываться с весами: разным участникам назначают разный вклад в оценку. Тогда числитель — сумма весов выбранной категории, знаменатель — сумма весов включённых наблюдений. Фактическое n по-прежнему означает число наблюдавшихся людей. Оно не обязано совпадать с суммой весов и должно быть отделено от неё в подписи или методическом пояснении.
В учебном примере шесть человек ответили «да», четыре — «нет». Без весов доля «да» равна 60%. Назначим каждому ответу «да» вес 1, каждому «нет» — вес 2: сумма весов станет 6 + 8 = 14, взвешенная доля «да» — 6 / 14, примерно 42,9%. Людей осталось десять, а ответов «да» — шесть. Умножение 42,9% на десять не восстановит число этих ответов.
Такие искусственные веса нужны только для объяснения арифметики и не предлагаются как способ исправить опрос. Реальные веса требуют обоснования. Возле взвешенного результата укажите, что процент взвешен, а n дано без весов, если это так. Не выдавайте вычисленное из процента приблизительное количество за наблюдённое. Если исходных чисел нет, честно оставьте их неизвестными.
Что n говорит о надёжности — и чего не говорит
Размер группы помогает увидеть, что за одинаковыми долями стоит разное количество данных. При сопоставимом случайном отборе больший объём обычно уменьшает случайную неопределённость, но само n не описывает способ отбора. Тысяча добровольных ответов из удобного канала не становится представительной выборкой только благодаря числу. Ошибки охвата, формулировка вопроса и особенности неответивших требуют отдельного рассмотрения.
Нет общего правила, по которому любой процент можно публиковать после достижения 30 или 100 ответов. Решение зависит от назначения результата, способа получения данных, требований к точности и допустимого раскрытия малых групп. При выборочных оценках доверительные интервалы должны соответствовать плану исследования и взвешиванию. Подставить n в первую найденную формулу недостаточно, особенно для сложного отбора.
Поэтому в этой статье нет интервалов для придуманных групп и вывода об отличиях населения. Для отчёта с реальными оценками нужны методика и данные исследования. Если неопределённость уже рассчитана корректно, выбирайте представление, где её можно прочитать вместе с оценкой. Полоса, доведённая до 100%, сама по себе такой информации не содержит.
Как подписать диаграмму перед публикацией
Для первого примера подойдёт подпись: «Учебные данные. Доля ответов “да” и “нет” внутри каждой группы: А — 50 участников, Б — 1 000. Один ответ на человека, пропусков нет, веса не применялись». Она задаёт происхождение, единицу, базу и важные правила. Для реальных данных добавьте источник и период, а при наличии фильтров — условия отбора, которые меняют смысл показателя.
Перед передачей отчёта проверьте пять вещей: совпадает ли вопрос с выбранной базой; указан ли размер каждой группы; не пересекаются ли части составной полосы; отличены ли нули от отсутствия данных; воспроизводится ли одна подпись делением исходных чисел. Затем прочитайте заголовок без пояснений автора. Если он обещает количество, а изображение показывает только долю, нужно изменить заголовок или само представление.
У столбцов и полос важна также шкала: их длину считывают от исходной линии. Обоснование нулевой базы и случаи, где другая шкала допустима, разобраны в статье об осях и базовых линиях графиков. Здесь задача уже: показать, что входит в сто процентов, сколько наблюдений за ними стоит и какой вывод эти данные действительно поддерживают.